
지난 글에서 Kimi K3와 Opus 5에 같은 프롬프트를 던져봤습니다.
K3는 10분에 $0.70, Opus 5는 43분에 $14.90가 나왔죠.
그런데 그 글을 쓰면서 계속 걸리는 게 하나 있었습니다.
그럼 제 3060은요?
K3는 2.8조 파라미터라 애초에 후보가 아닙니다.
하지만 12GB 카드에 올릴 수 있는 모델 중에도 쓸 만한 게 있지 않을까 싶었습니다.
그래서 이번엔 Claude Code 로컬 LLM 연결에 도전해봤습니다.
llama.cpp를 깔고, Qwen3.6 35B-A3B를 올리고, Claude Code를 거기에 붙였습니다.
결론부터 말씀드리면 6분 14초에 1,374줄짜리 게임이 나왔습니다.
실제로 플레이도 됩니다. 비용은 $0.00이고 그래픽카드 전력은 97W를 썼습니다.
바로 가시죠.
Claude Code 로컬 LLM 결과부터
| 시간 | 비용 | 결과물 | |
|---|---|---|---|
| Kimi K3 | 10분 | $0.70 | 완성 |
| Opus 5 | 43분 | $14.90 | 완성 |
| Qwen3.6 35B-A3B (로컬) | 6분 14초 | $0.00 | 1,374줄, 플레이 가능 |
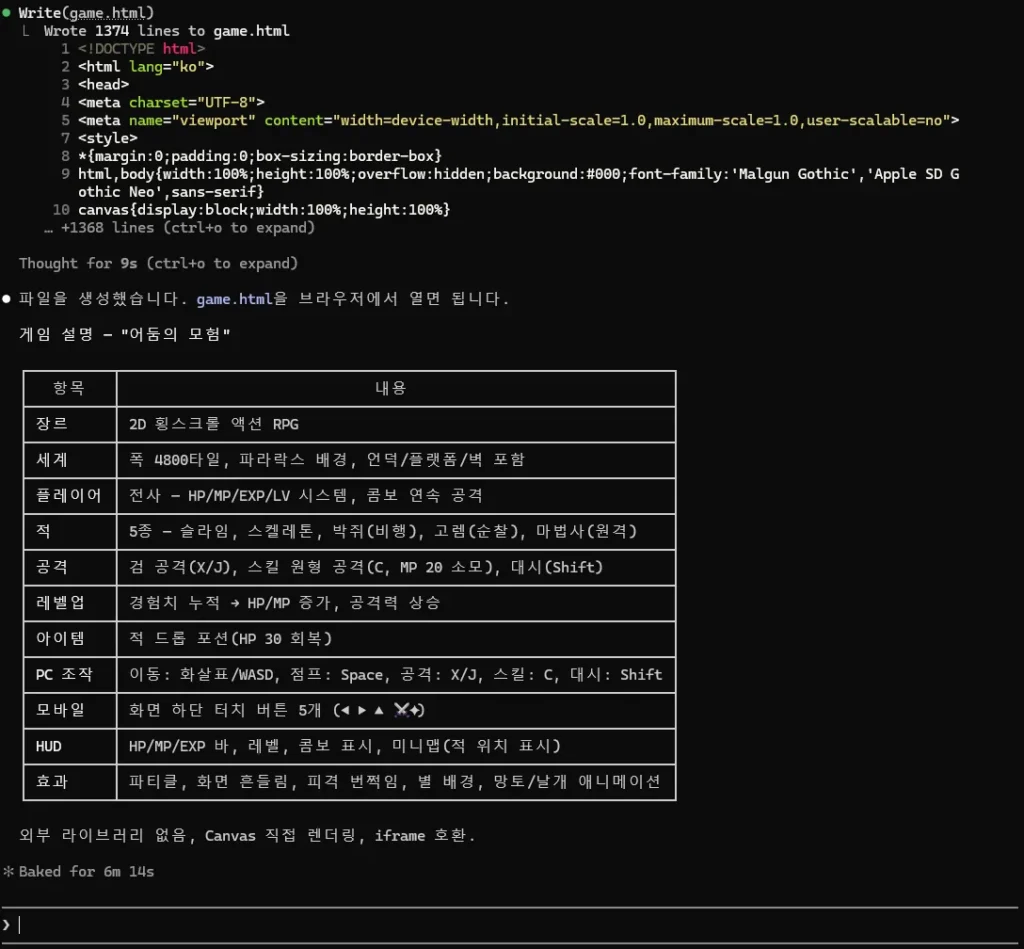
Write(game.html) → Wrote 1374 lines to game.html → Baked for 6m 14s.
Claude Code 로컬 LLM 조합이 클라우드 모델보다 빨랐습니다.
다만 미리 짚어둘 게 하나 있습니다. 6분 14초는 여러 번 돌린 것 중 하나입니다.
같은 프롬프트로 다섯 번쯤 돌려봤는데 4분 39초부터 12분 53초까지 편차가 있었습니다.
매번 다른 경로를 타거든요. 대략 6~13분으로 보시는 게 맞습니다.
K3의 10분과 Opus 5의 43분도 각각 한 번씩 잰 숫자일 테니 같은 한계가 있을 겁니다.
플레이 화면은 이렇게 나왔습니다.
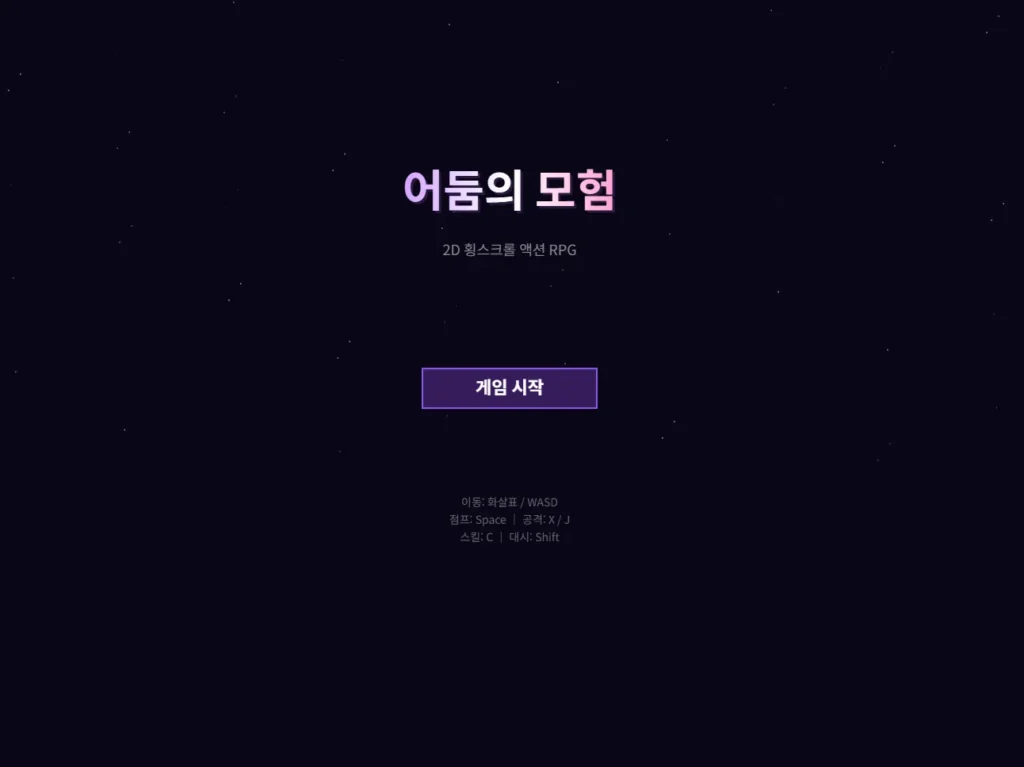

Lv.5까지 올려봤습니다.
별 배경, 파라락스 언덕, 플랫폼, 슬라임·박쥐·스켈레톤, 우상단 미니맵, HP/MP/EXP 바까지 다 돌아갑니다.
공격 모션이 안 보이는 버그가 하나 있는데 공격 판정 자체는 먹힙니다.
직접 해보고 싶으시면 → 데모 플레이
Claude Code 로컬 LLM 준비물
1. llama.cpp 설치
Claude Code 로컬 LLM 연결의 출발점은 추론 서버입니다.
Ollama가 아니라 llama.cpp를 직접 씁니다.
이유는 뒤에서 자세히 다루겠지만, 요약하면 제어 손잡이가 필요해서입니다.
llama.cpp는 홈페이지가 따로 없습니다. GitHub 저장소가 곧 배포처입니다.

오른쪽 Releases를 눌러 최신 릴리스로 들어가서, Assets 목록을 펼칩니다.

받아야 할 파일은 두 개입니다.
llama-bXXXXX-bin-win-cuda-12.4-x64.zip: 본체cudart-llama-bin-win-cuda-12.4-x64.zip: CUDA 런타임 (373MB)
여기서 처음 하시는 분들이 제일 많이 헤맵니다. 목록에 파일이 29개나 있고 대부분이 리눅스·맥·ARM용이거든요.
윈도우 + NVIDIA면 이름에 bin과 win-cuda가 둘 다 들어간 걸 고르셔야 합니다.Source code (zip)을 받으면 소스코드라 컴파일을 직접 해야 합니다. 저도 처음에 이거 받아서 한참 헤맸습니다.
두 zip은 같은 폴더에 푸셔야 합니다.
런타임 DLL이 실행 파일 옆에 있어야 동작하거든요. 저는 C:\llama에 넣었습니다.
버전 숫자(12.4 / 13.3)는 둘 중 아무거나 쓰셔도 되는데, 본체와 런타임의 숫자를 일치시켜야 합니다.
2. 전력 제한 (선택)
이건 필수가 아닌데, 해두면 이득이 큽니다.
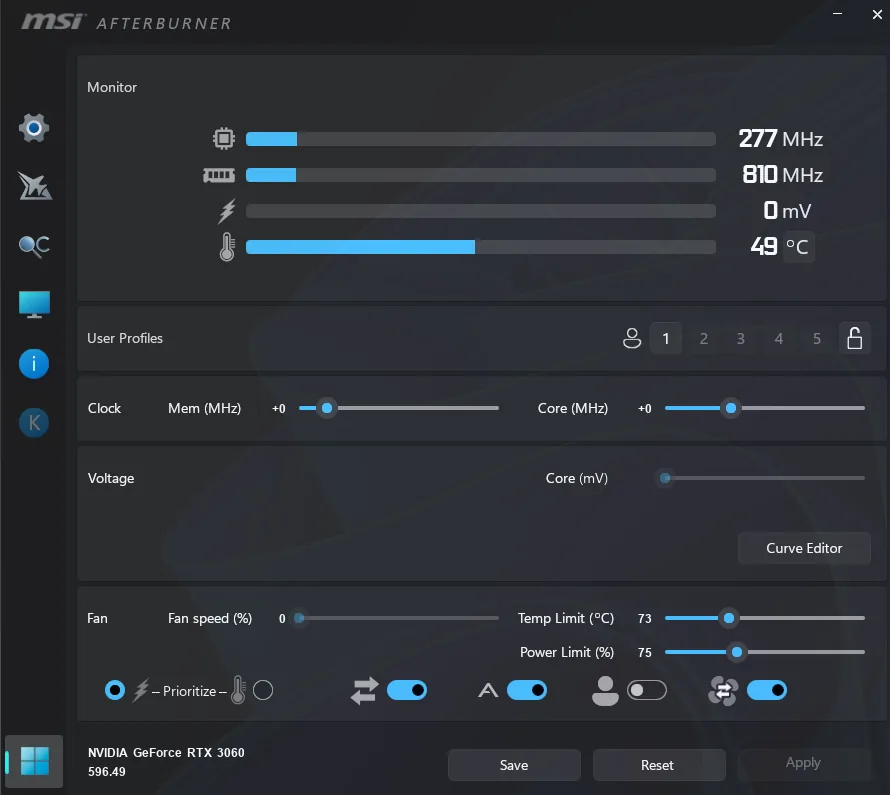
MSI Afterburner에서 Power Limit을 75%로 내렸습니다. 3060 기본 TDP가 170W니까 약 127W가 됩니다.
로컬 LLM 추론은 메모리 대역폭에 묶인 작업이라 전력 여유를 다 못 씁니다. 뒤에 나오지만 실제로 추론 중에 97W밖에 안 썼습니다. 제한이 병목이 아니었다는 뜻이죠.
3. 모델 받고 서버 띄우기
cd C:\llama
.\llama-server.exe -hf unsloth/Qwen3.6-35B-A3B-MTP-GGUF:UD-Q4_K_M `
  --ctx-size 131072 -np 1 -ngl 99 --n-cpu-moe 32 `
  --no-mmap --flash-attn on `
  --spec-type draft-mtp --spec-draft-n-max 2 --port 8080
-hf 플래그가 HuggingFace에서 모델을 알아서 받아옵니다. 22GB라 처음엔 시간이 좀 걸립니다. 한 번 받으면 캐시에 남아서 다음부터는 바로 로딩됩니다.
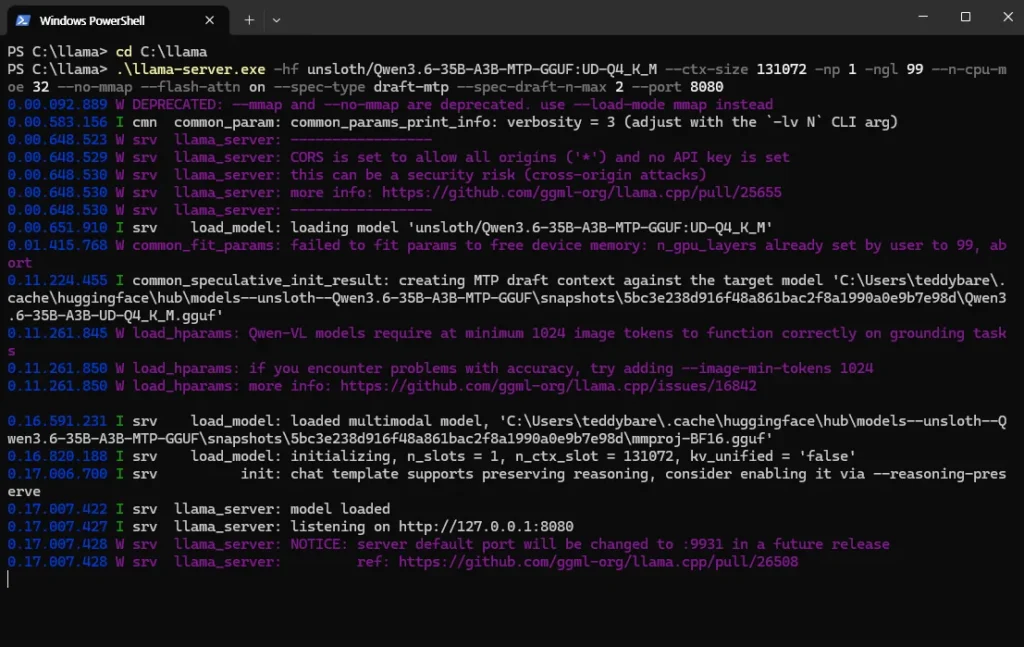
로그에서 확인하실 게 세 줄입니다.
creating MTP draft context against the target model: MTP가 켜졌습니다n_slots = 1, n_ctx_slot = 131072: 슬롯 1개, 컨텍스트 128Klistening on http://127.0.0.1:8080: 서버 기동 완료
플래그 하나하나가 무슨 뜻인가
이 명령줄이 Claude Code 로컬 LLM 세팅의 핵심입니다. 하나씩 뜯어보겠습니다.
--n-cpu-moe 32: 22GB를 12GB에 넣는 방법
Qwen3.6 35B-A3B는 MoE(Mixture of Experts) 모델입니다. 총 350억 파라미터지만 토큰 하나 만들 때 36억만 활성화됩니다.
전문가(expert)가 여러 명 있는데 매번 몇 명만 부르는 구조죠. 여기서 핵심은 안 불린 전문가는 GPU에 있을 필요가 없다는 겁니다.
--n-cpu-moe 32는 앞쪽 32개 레이어의 전문가 가중치를 시스템 RAM으로 내립니다. 어텐션은 GPU에 남습니다.
레이어를 통째로 내리는 게 아니라 전문가만 내리는 거라 -ngl 99(전부 GPU에)와 모순되지 않습니다.
이 숫자는 직접 스윕해서 찾으셔야 합니다. 낮출수록 GPU를 더 쓰고 빨라지지만, 넘치면 OOM이 납니다. 저는 32에서 안정적이었습니다.
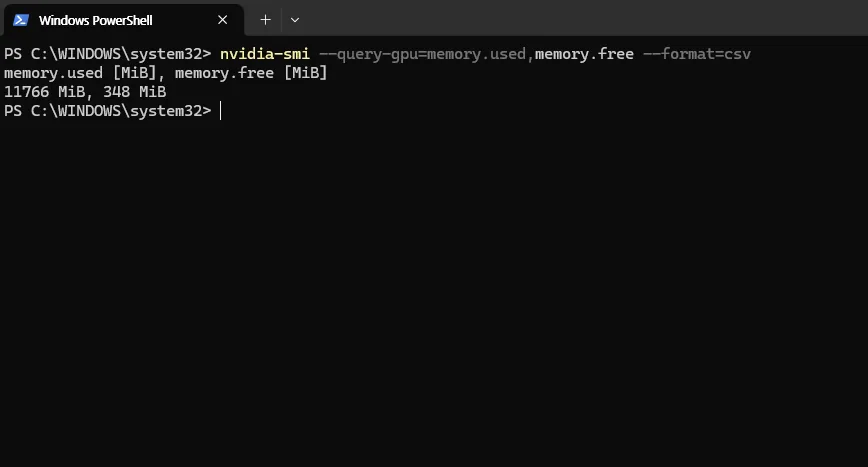
memory.used: 11766 MiB / memory.free: 348 MiB
12GB 중 11.7GB를 쓰고 348MB만 남았습니다. 아슬아슬하죠.
컨텍스트를 256K로 올려봤더니 여유가 82MB까지 떨어져서 128K로 되돌렸습니다. --n-cpu-moe는 모델 가중치만 내리지 KV 캐시는 못 내리거든요. 컨텍스트를 늘리면 그만큼 VRAM이 더 필요합니다.
--spec-type draft-mtp: 공짜 속도
MTP(Multi-Token Prediction)는 모델 안에 이미 들어있는 작은 예측기를 쓰는 기술입니다.
보통 LLM은 토큰 하나 만들 때마다 22GB 가중치를 통째로 훑습니다. 3060의 대역폭 360GB/s로 나누면 물리적 상한이 나오죠. 이게 느린 이유입니다.
MTP는 작은 예측기가 다음 토큰 2~3개를 미리 찍고, 본체가 그걸 한 번에 검증합니다. 여러 개를 동시에 검사하는 비용이 하나씩 만드는 것보다 훨씬 쌉니다. 맞은 것만 채택하고 틀리면 버립니다.
품질은 안 떨어집니다. 초안이 틀리면 폐기하니까 최종 출력은 MTP 없이 만든 것과 동일합니다.
여기서 함정이 하나 있습니다. --spec-type draft-mtp 플래그를 안 주면 MTP 가중치가 그냥 무시됩니다.
저도 처음엔 이걸 몰라서 MTP 레포에서 받아놓고 일반 모델로 돌리고 있었습니다. 로그에 이런 게 잔뜩 뜨면 안 켜진 겁니다.
W model has unused tensor blk.40.nextn.eh_proj.weight -- ignoring
-np 1: 12GB에서는 선택지가 없습니다
--parallel의 줄임말이고, 서버가 동시에 처리할 요청 개수입니다. 기본값은 4입니다.
이거 하나 안 줬다가 크게 헤맸습니다.
첫 번째 문제는 컨텍스트가 쪼개진다는 겁니다.
--ctx-size 131072를 줬으니 128K가 잡힐 줄 알았는데, 슬롯 4개면 슬롯당 32,768로 나뉩니다. 그리고 Claude Code 시스템 프롬프트만 32,357 토큰입니다.
거의 딱 맞아떨어져서 첫 턴부터 넘칩니다.
E srv send_error: task id = 212, error: request (34247 tokens)
  exceeds the available context size (32768 tokens), try increasing it

● API Error: 400 request (34247 tokens) exceeds the available context size (32768 tokens)
그럼 컨텍스트를 늘리면 되지 않느냐 하실 텐데, 슬롯당 128K를 쓰려면 --ctx-size 524288을 줘야 합니다.
그런데 128K에서도 VRAM 여유가 348MB뿐이었습니다. KV 캐시를 4배로 잡으면 감당이 안 됩니다.
--n-cpu-moe를 크게 올려서 억지로 밀어넣을 수는 있겠지만, 그러면 GPU에 남는 게 줄어서 속도가 떨어집니다. 어느 쪽이든 손해죠.
VRAM이 넉넉한 카드라면 얘기가 다를 수 있는데, 12GB에서는 -np 1이 사실상 유일한 선택입니다.
두 번째는 GPU를 나눠 쓴다는 겁니다.
Claude Code는 요청을 하나만 보내지 않습니다. 본 작업 말고 제목 생성, 요약, 안전성 판정 같은 걸 병렬로 던지거든요.
슬롯이 여러 개면 이것들이 GPU를 나눠 씁니다.
id 3 | task 0 | n_decoded = 4904, tg = 25.60 t/s
id 2 | task 2 | n_decoded = 4901, tg = 27.18 t/s
두 슬롯이 각각 25, 27로 돕니다. 합치면 52라 서버 총 처리량은 늘지만, 제가 기다리는 답 하나만 보면 그만큼 느려진 셈이죠.
다만 이 측정은 MTP를 켜기 전이라, 슬롯 설정만의 효과를 분리해서 재보진 못했습니다. 컨텍스트 4등분 문제 때문에 같은 조건으로 재현이 안 되더군요.
어쨌든 혼자 쓰는 환경이면 -np 1이 맞습니다.
Claude Code 로컬 LLM 연결하기
Claude Code는 본질적으로 Anthropic Messages API 형식으로 말하는 클라이언트입니다. 그리고 반대편에 진짜 Claude가 있는지 검증하지 않습니다.
llama.cpp가 그 형식을 네이티브로 지원하니까 프록시도 변환 계층도 필요 없습니다.
새 PowerShell 창을 열고(서버 창은 그대로 둡니다) 이렇게 칩니다.
cd C:\test
$env:ANTHROPIC_BASE_URL="http://localhost:8080"
$env:ANTHROPIC_AUTH_TOKEN="local"
$env:ANTHROPIC_API_KEY=""
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS="131072"
claude --model qwen3.6-35b-a3b
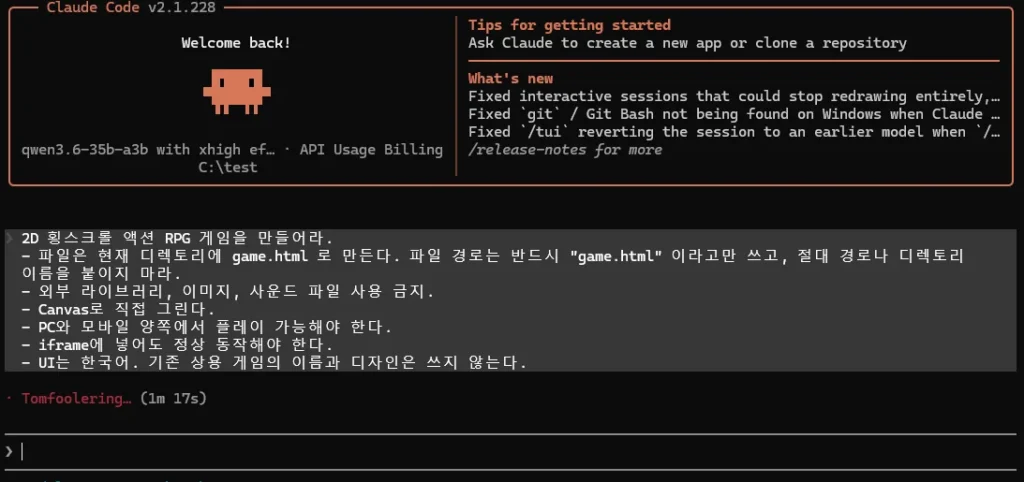
상단 박스에 qwen3.6-35b-a3b · API Usage Billing이 뜨면 성공입니다. Claude Max라고 나오면 환경변수가 안 먹은 겁니다.
환경변수는 이 창에만 유효합니다. 창을 닫으면 원래 구독 Claude Code로 돌아갑니다.
시스템 환경변수에 등록하면 모든 창이 로컬로 가버리니 실험용으로는 이게 낫습니다.
--model 뒤의 이름은 아무거나 주셔도 됩니다. llama-server는 물고 있는 모델이 하나뿐이라 이름을 무시합니다.
프롬프트와 실행
지난 글과 정확히 같은 프롬프트를 썼습니다. 파일 경로 조건 한 줄만 추가했습니다.
2D 횡스크롤 액션 RPG 게임을 만들어라.
- 파일은 현재 디렉토리에 game.html 로 만든다. 파일 경로는 반드시 "game.html"
  이라고만 쓰고, 절대 경로나 디렉토리 이름을 붙이지 마라.
- 외부 라이브러리, 이미지, 사운드 파일 사용 금지.
- Canvas로 직접 그린다.
- PC와 모바일 양쪽에서 플레이 가능해야 한다.
- iframe에 넣어도 정상 동작해야 한다.
- UI는 한국어. 기존 상용 게임의 이름과 디자인은 쓰지 않는다.
엔터를 치면 서버 창에 이런 게 흐릅니다.
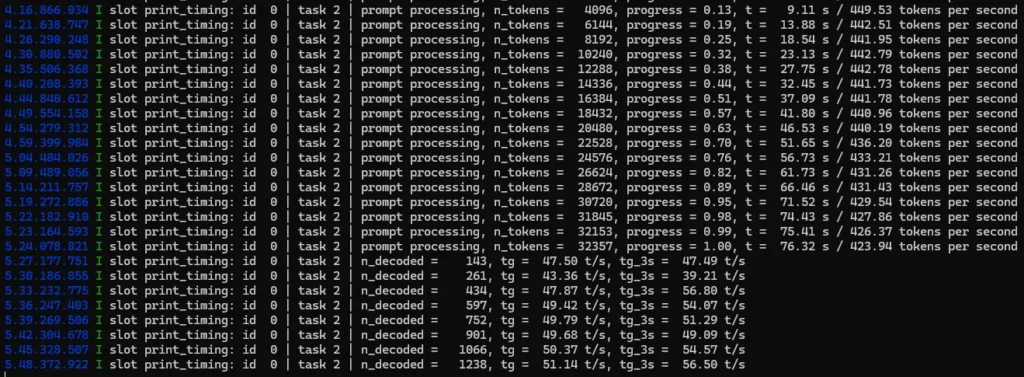
여기서 놀란 숫자가 하나 있습니다.
prompt processing, n_tokens = 32357, progress = 1.00, t = 76.32 s / 423.94 tok/s
제가 친 건 프롬프트 7줄인데 32,357 토큰을 삼켰습니다.
나머지 3만 2천은 Claude Code의 시스템 프롬프트입니다. 도구 정의, 행동 규칙, 코딩 컨벤션 같은 것들이 매 요청에 얹힙니다.
프리필에만 76초가 걸립니다. 이게 Claude Code 로컬 LLM 조합에서 지불하는 고정 비용입니다.
얼마나 빠른가
프리필이 끝나면 생성이 시작됩니다.
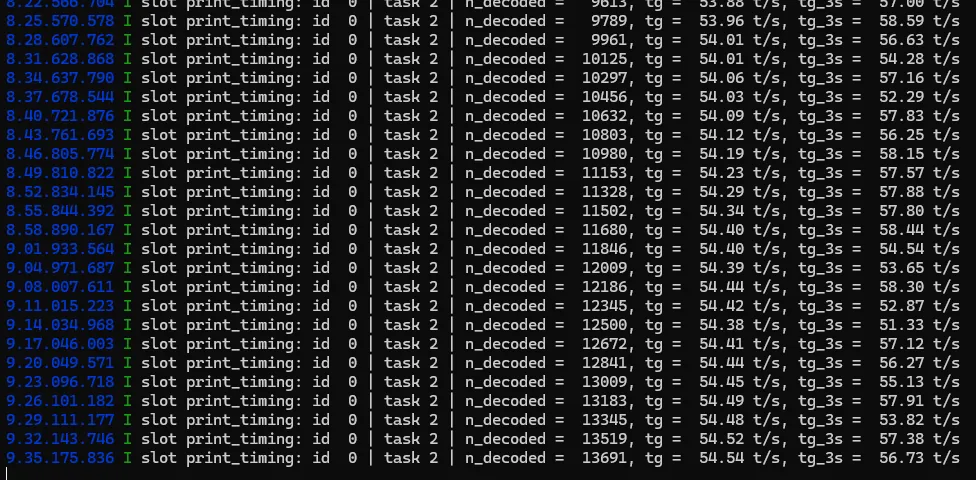
tg_3s(최근 3초 속도)를 따라가면 재밌는 게 보입니다.
n_decoded =   143, tg = 47.50 t/s, tg_3s = 47.49 t/s
n_decoded =   261, tg = 43.36 t/s, tg_3s = 39.21 t/s   ← 사고 구간
n_decoded =   434, tg = 47.87 t/s, tg_3s = 56.80 t/s   ← 코드 진입
...
n_decoded = 13691, tg = 54.54 t/s, tg_3s = 56.73 t/s
초반 39에서 후반 57~58로 오릅니다. 보통 긴 출력에서는 어텐션이 누적돼서 속도가 떨어지는데 여기선 반대죠.
이유는 MTP입니다. 사고 과정이나 자연어 설명은 다음 단어 예측이 어려워서 초안이 자주 틀립니다.
반면 HTML/JS 코드는 문법이 예측 가능합니다. function 다음에 (, ctx.fillRect 다음에 (. 이런 건 안 틀리거든요.
세션이 끝나면 정확한 수치가 찍힙니다.

prompt eval time = 76412.55 ms / 32361 tokens (423.50 tokens per second)
       eval time = 268793.20 ms / 14678 tokens ( 54.61 tokens per second)
draft acceptance = 0.84537 (9223 accepted / 10910 generated), mean len = 2.69
드래프트 채택률 84.5%입니다.
10,910개를 초안으로 뽑아서 9,223개가 통과했습니다. 평균 2.69토큰씩 한 번에 처리한 셈이죠.
참고로 코드 생성이 아닌 짧은 요청(같은 로그의 task 5861)은 채택률이 70.9%였습니다.
코드에서 특히 잘 먹는다는 게 숫자로 나옵니다.
전력은 얼마나 쓰나
추론이 한창일 때 재봤습니다.
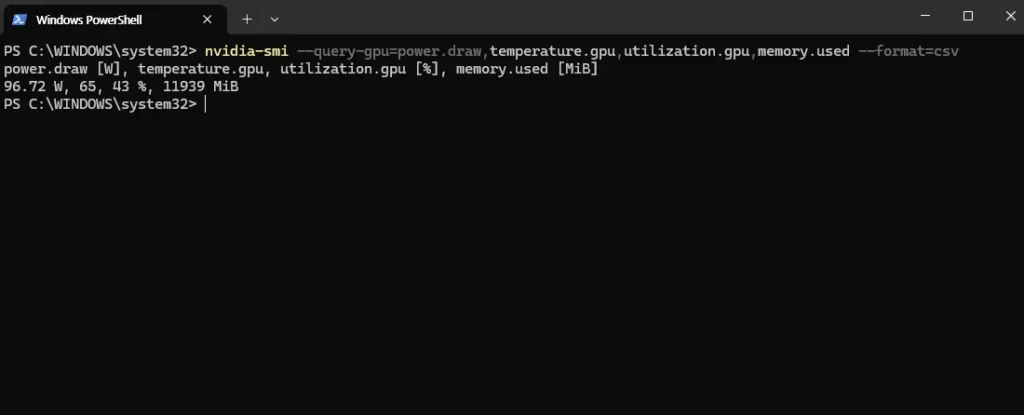
power.draw: 96.72 W | temperature: 65°C | utilization: 43% | memory: 11939 MiB
97W입니다. 제한을 127W로 걸어놨는데 그 76%만 씁니다. GPU 사용률도 43%로 절반이 안 됩니다.
MoE 오프로딩 때문입니다. 전문가 가중치가 시스템 RAM에 있어서 GPU가 데이터를 기다리는 시간이 있거든요.
그래서 전력 제한을 걸어도 손해가 거의 없습니다. 오히려 100W 근처까지 더 내려도 될 것 같습니다.
22GB 모델을 100W도 안 쓰고 돌린다는 건 꽤 괜찮은 그림입니다.
비용 화면의 함정
작업이 끝나고 /usage를 쳐봤습니다.
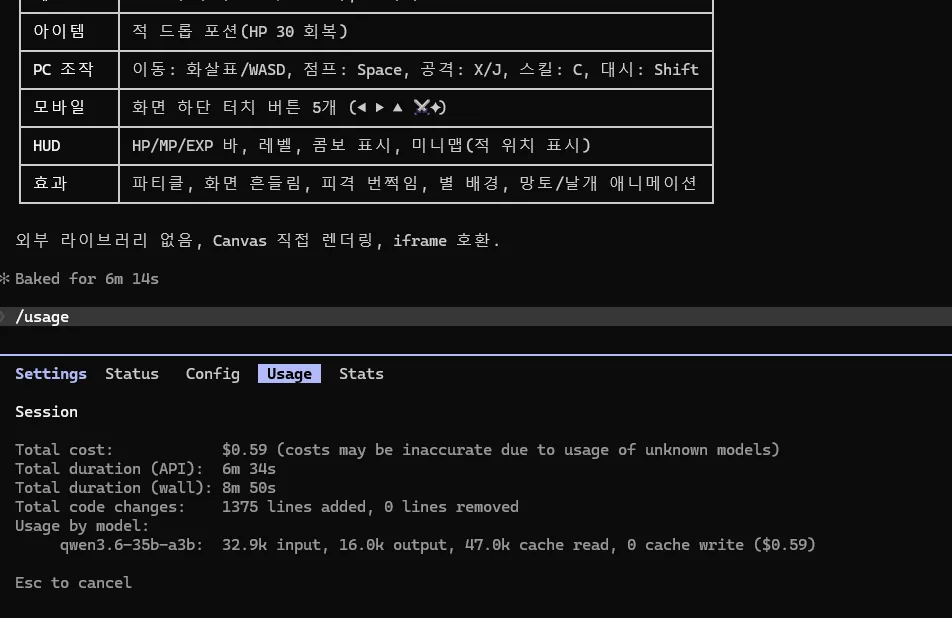
Total cost: $0.59 (costs may be inaccurate due to usage of unknown models)
Total duration (API):  6m 34s
Total duration (wall): 8m 50s
Total code changes: 1375 lines added, 0 lines removed
qwen3.6-35b-a3b: 32.9k input, 16.0k output, 47.0k cache read, 0 cache write
$0.59는 가짜입니다. Claude Code가 Anthropic 요금표로 계산한 숫자입니다. 로컬이니 실제 비용은 $0.00이죠.
다만 역으로 유용한 정보이긴 합니다. 같은 작업을 클라우드에서 했다면 0.6달러쯤 나왔다는 뜻이니까요.
주목할 건 47.0k cache read입니다.
Claude Code는 매 턴 전체 대화를 통째로 보냅니다. 모델이 상태를 기억 못 하니까요. 그런데 앞부분이 지난번과 같으면 계산 결과를 재활용합니다. 그게 캐시입니다.
이 세션에서는 4만 7천 토큰이 캐시에서 나왔습니다.
캐시가 없었다면 그만큼을 매번 다시 프리필해야 했습니다.
423 tok/s로 나누면 매 턴 110초씩 추가로 붙는다는 뜻이죠.
Claude Code 로컬 LLM 조합에서 이 캐시가 되느냐 마느냐가 체감을 완전히 갈라놓습니다.
그리고 화면 하단의 Session / Weekly 퍼센트는 원래 쓰던 Max 구독의 잔여치가 표시된 겁니다. 로컬로 라우팅 중이라 이 작업과 직접 관계는 없습니다.
결과물의 품질
1,374줄이 나왔고 브라우저에서 바로 돌아갔습니다. 프롬프트에 없던 것들도 알아서 넣었더군요.
- 적 5종 (슬라임, 스켈레톤, 박쥐, 골렘, 마법사), 각각 다른 AI
- 레벨업, 경험치, 콤보 시스템
- 미니맵, 파티클, 화면 흔들림
- 모바일 터치 버튼 5개
- 파라락스 배경
조건도 다 지켰습니다. 외부 라이브러리 없음, Canvas 직접 렌더링, 한국어 UI, 기존 게임 베끼지 않음.
다만 완벽하진 않습니다. 공격 모션이 렌더링되지 않는 버그가 있습니다. 판정은 먹히는데 그림이 안 그려집니다.
이게 Claude Code 로컬 LLM 조합의 전형적인 패턴입니다. 여러 번 돌려보면서 관찰한 건, 구조와 렌더링은 잘 짜는데 입력 처리나 상태 전이 같은 “배선”을 빠뜨린다는 겁니다.
어떤 회차에서는 키보드 입력 처리가 통째로 빠져서 캐릭터가 아예 안 움직였습니다.
그런데 이건 고칠 수 있습니다. 버그를 설명해주면 스스로 찾아서 고칩니다.
다른 회차에서는 자기가 만든 1,409줄에서 중괄호가 하나 부족한 걸 발견하고, node -e로 괄호 개수를 세는 스크립트를 짜서 위치를 특정한 다음 고쳤습니다. 그 정도는 합니다.
“한 번에 완성되지 않는다, 1~2턴의 디버깅이 필요하다.” 이게 정직한 표현입니다.
왜 Ollama가 아니라 llama.cpp인가
Claude Code 로컬 LLM 얘기를 하면 대부분 Ollama부터 떠올리실 겁니다.
사실 저도 처음엔 Ollama로 시작했습니다. 이미 깔려 있었고, ollama pull 한 줄이면 되고
최근 버전엔 Claude Code를 바로 띄우는 런처까지 들어갔거든요.
안 쓸 이유가 없었습니다.
그런데 같은 프롬프트를 던지니 이런 게 떴습니다.
Thought for 10m 0s
⎿  Error writing file
✻ API error · Retrying in 0s · attempt 1/10
✻ Request timed out. · Retrying in 0s · attempt 8/10
● API Error: Response stalled mid-stream. The response above may be incomplete.
10분을 사고하고 파일 쓰기에서 실패합니다. 재시도를 걸면 프리필부터 처음 다시 합니다. 그리고 또 실패합니다.
여섯 번 돌려서 여섯 번 다 실패했습니다. 한 번은 16분 52초를 태우고 코드 한 줄도 못 건졌습니다.
원인을 찾아보려 했는데
가능한 걸 하나씩 지워봤습니다.
작업 경로? 긴 경로(IdeaProjects\LLM)에서 실패하길래 C:\g2로 옮겨봤습니다. 똑같이 실패했습니다.
컨텍스트 누적? /clear로 깨끗하게 시작해봤습니다. 똑같았습니다.
모델 파일? Ollama가 배포한 GGUF 대신 llama.cpp에서 쓰던 Unsloth 파일을 Modelfile로 등록해서 넣어봤습니다. 똑같이 실패했습니다.
작업 크기? 여기서 실마리가 나왔습니다. 24줄짜리 테스트는 성공합니다. 450줄짜리 가계부 앱도 성공합니다. 488줄짜리 플랫포머도 됩니다.
1,400줄대 게임만 안 됩니다.
그럼 뭔가 시간이나 크기 제한이 있는 건가 싶었습니다. 서버 로그를 켜봤습니다.
[GIN] 2026/08/09 - 19:07:51 | 500 | 4m13s | POST "/v1/messages?beta=true"
srv stop: cancel task, id_task = 7655
slot release: stop processing: n_tokens = 39557
4분 13초에 500 에러를 내고 요청을 취소합니다. 그 시점에 서버는 39,557 토큰까지 멀쩡히 만들고 있었습니다.
Claude Code 화면엔 “네트워크를 확인하라”고 떠 있는데 모델은 36 t/s로 열심히 돌고 있는 상황이었죠.
고정 타임아웃인가 싶었는데, gpt-oss 20B로 돌려보니 7분 15초짜리 요청이 200으로 정상 완료됐습니다. 가설이 깨졌습니다.
알고 보니 같은 엔진이었습니다
여기서 프로세스를 들여다봤습니다.
Get-CimInstance Win32_Process -Filter "name='llama-server.exe'" |
  Select-Object ExecutablePath, CommandLine | Format-List
ExecutablePath : C:\Users\...\AppData\Local\Programs\Ollama\lib\ollama\llama-server.exe
CommandLine    : ... --port 60224 --host 127.0.0.1 --no-webui --offline -c 131072
                 -np 1 --log-verbosity 4 --no-mmap --cache-type-k q8_0
                 --cache-type-v q8_0 --flash-attn on -b 512 -ub 512
                 --context-shift --keep 4
Ollama도 llama-server.exe를 띄우고 있었습니다.
두 도구가 다른 엔진을 쓰는 게 아니라, 같은 엔진에 다른 플래그를 넘기고 있었던 거죠.
그래서 저 플래그를 통째로 복사해서 제 llama-server에 그대로 줘봤습니다. KV 캐시 양자화, 배치 크기 512, --context-shift까지 전부요.
그래도 성공했습니다. 1,698줄, 11분 19초.
VRAM도 의심해봤습니다. Ollama는 자동 피팅으로 여유를 1,085MB만 남기고 꽉 채웁니다.
그래서 --n-cpu-moe를 낮춰 여유 672MB까지 더 빡빡하게 만들어놓고 돌려봤습니다. 이번에도 성공했습니다.
결론: 저도 모르겠습니다..
정리하면 이렇습니다.
| 검증한 가설 | 결과 |
|---|---|
| 작업 경로 길이 | 반증 (짧은 경로에서도 실패) |
| 컨텍스트 누적 | 반증 (/clear 후에도 실패) |
| GGUF 파일 차이 | 반증 (같은 파일로도 실패) |
| 서버 플래그 | 반증 (플래그 복제해도 llama.cpp는 성공) |
| VRAM 부족 | 반증 (더 빡빡하게 해도 llama.cpp는 성공) |
| 4분 고정 타임아웃 | 반증 (7분 15초 요청이 200으로 완료) |
후보를 여섯 개 세웠고 여섯 개 다 지워졌습니다.
남은 건 Ollama가 llama-server 위에 얹은 Anthropic 호환 계층 어딘가인데, 거기까지는 파고들지 못했습니다.
눈에 걸리는 정황이 두 개 있긴 합니다.
하나는 /usage의 cache read가 Ollama 경유에서는 항상 0이었다는 겁니다. llama.cpp는 47k였고요.
다른 하나는 Ollama 쪽 출력에만 중국어가 섞여 나온다는 겁니다.
같은 가중치인데 “总收入, 支출, 화箭右” 같은 중국어가 나왔습니다.
llama.cpp 세션 다섯 번에서는 한 번도 없었습니다.
채팅 템플릿 처리가 다른 게 아닌가 싶지만 확인은 못 했습니다.
그래서 뭘 쓰라는 건가
Claude Code 로컬 LLM을 작은 작업에만 쓰신다면 Ollama가 편합니다.
500줄 안팎까지는 양쪽 다 잘 됩니다. ollama pull 한 줄이면 되고 런처도 있고요.
1,000줄 넘는 걸 한 번에 뽑아야 하면 llama.cpp입니다.
저는 대형 작업에서 llama.cpp 5번 시도, 5번 모두 성공, Ollama 6번 시도, 6번 모두 실패…
왜 갈리는지는 못 밝혔지만 결과는 일관됐습니다.
그리고 llama.cpp를 쓰면 부수적으로 얻는 게 있습니다. 서버 로그가 다 보입니다.
이 글에 나온 423 tok/s, tg_3s = 57, draft acceptance 0.845 같은 숫자는 전부 llama-server가 직접 찍어준 겁니다. 애초에 이 문제를 추적할 수 있었던 것도 그 로그 덕이었습니다.
그래서 Claude Code 로컬 LLM, 쓸 만한가
됩니다.
3060 12GB에서, 97W로, 공짜로, 6분 만에 1,374줄이 나왔고 실제로 플레이됐습니다.
다만 조건이 세 개 붙습니다.
llama.cpp로 서빙해야 하고, 플래그를 제대로 줘야 하고, 한 번에 완성되진 않습니다.
이걸 감수할 수 있으면 실용적이고, 못 하면 아직 클라우드가 낫습니다.
용도별로 정리하면 이렇습니다.
쓸 만한 경우
- 코드가 밖으로 나가면 안 되는 작업
- 토큰 한도를 신경 쓰지 않고 무한정 돌리고 싶을 때
- 인터넷 없는 환경
- 실험적으로 이것저것 던져보는 작업
아직 아닌 경우
- 즉답이 필요한 대화형 작업. 매 턴 프리필 76초가 붙습니다
- 한 번에 정확히 맞혀야 하는 작업. 디버깅 턴이 필요합니다
- 대규모 리팩터링. 컨텍스트가 금방 찹니다
가장 큰 차이는 속도가 아니라 예측 가능성입니다.
6분에 끝날 수도 있고 13분이 걸릴 수도 있습니다.
결과물이 바로 돌아갈 수도 있고 버그가 두어 개 있을 수도 있습니다.
클라우드 모델은 그 편차가 훨씬 작죠.
하지만 1년 전만 해도 집에서 코딩 에이전트를 돌린다는 건 상상도 못했는데
지금은 그래픽카드 한 장으로 됩니다. 신기하지 않나요?
요약 이대로 따라 하시면 됩니다
# 1. GitHub Releases에서 두 개 받아서 C:\llama 에 같이 압축 해제
#    llama-bXXXXX-bin-win-cuda-12.4-x64.zip
#    cudart-llama-bin-win-cuda-12.4-x64.zip

# 2. 서버 (창 A)
cd C:\llama
.\llama-server.exe -hf unsloth/Qwen3.6-35B-A3B-MTP-GGUF:UD-Q4_K_M `
  --ctx-size 131072 -np 1 -ngl 99 --n-cpu-moe 32 `
  --no-mmap --flash-attn on `
  --spec-type draft-mtp --spec-draft-n-max 2 --port 8080

# 3. Claude Code (창 B)
cd C:\작업폴더
$env:ANTHROPIC_BASE_URL="http://localhost:8080"
$env:ANTHROPIC_AUTH_TOKEN="local"
$env:ANTHROPIC_API_KEY=""
$env:CLAUDE_CODE_MAX_CONTEXT_TOKENS="131072"
claude --model qwen3.6-35b-a3b
Claude Code 로컬 LLM 세팅(Qwen3.6 35b)은 이 세 단계가 전부입니다.
필요한 것: RTX 3060 12GB, 시스템 RAM 32GB, 디스크 25GB
놓치면 손해 보는 것 세 가지
--spec-type draft-mtp: 없으면 MTP가 무시됩니다-np 1: 없으면 컨텍스트가 4등분됩니다. 12GB에서는 이걸 만회할 VRAM이 없습니다--n-cpu-moe스윕: 이 숫자가 성패를 가릅니다
혹시 같은 Claude Code 로컬 LLM 조합에서 Ollama로 대형 작업이 성공하신 분이 있다면 어떤 설정이었는지 알려주시면 좋겠습니다. 여섯 개 가설을 다 지우고도 원인을 못 찾은 채로 남겨두는 게 영 개운치 않네요.