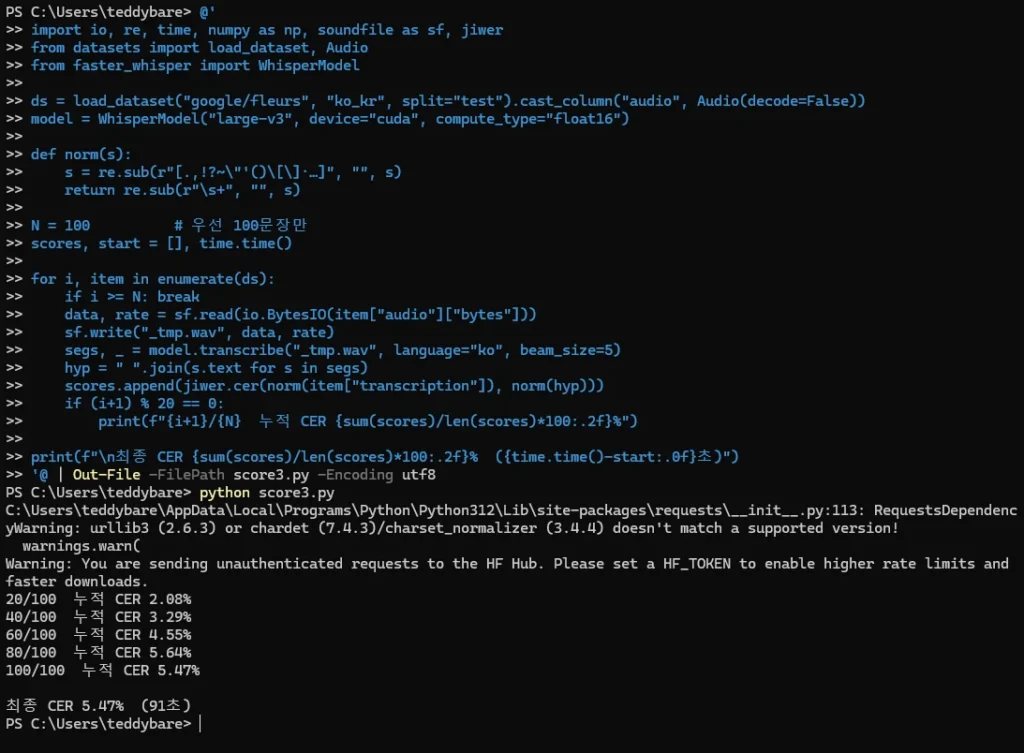
RTX 3060 Whisper large-v3 한국어 100문장 CER 5.47퍼센트 측정 결과
로컬 LLM

RTX 3060 Whisper 한국어 83분을 14분에 CER 5.47%

지난 글에서 J4125 미니PC에 로컬 LLM을 올려봤습니다.초당 2토큰이었습니다. “안녕하세요” 한마디에 1분이 걸렸죠.그 글은 이렇게 끝냈습니다. “사람이 앞에서 기다리지 않는 작업이라면 초당 2토큰이어도 상관없다”고요. 그런데 생각해보니 이 블로그는 그동안 텍스트만 다뤘습니다.젬마4 12B, gpt-oss 20B, Qwen3.6 35B-A3B, 그리고 이미지 생성까지 갔는데 소리는 한 번도 안 건드렸습니다. 그래서 이번엔 RTX 3060 Whisper입니다.음성 파일을 넣으면 텍스트로 받아써주는 STT(Speech to […]
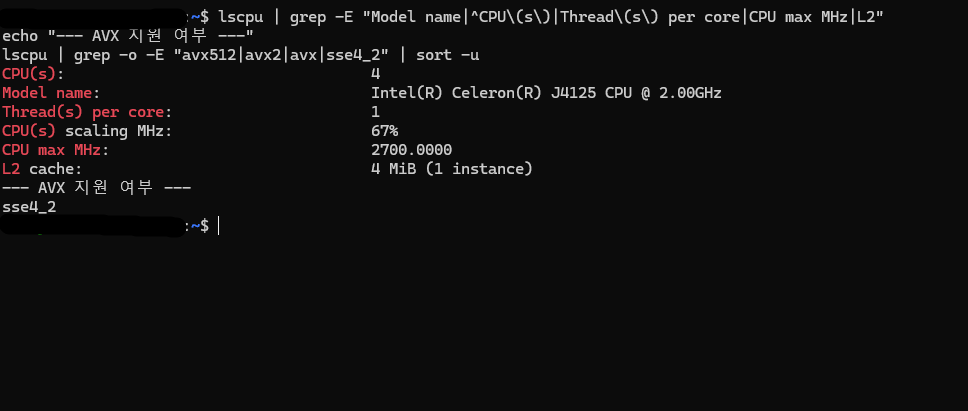
J4125 로컬 LLM을 위해 lscpu로 확인한 셀러론 CPU의 AVX 미지원 화면
로컬 LLM

J4125 로컬 LLM 돌리기 Gemma 4 E2B 초당 2토큰의 현실

지난 글에서 미니PC로 NAS를 만들었습니다.ASUS PN40, 셀러론 J4125에 램 8GB짜리입니다.소비전력 10W라 24시간 켜두고 있는데, 그러다 보니 욕심이 생겼습니다. J4125 로컬 LLM은 과연 실용성이 있을까요? 이 블로그에서는 주로 RTX 3060으로 로컬 LLM을 돌렸습니다.그런데 GPU가 없는 2019년 셀러론이라면 이야기가 완전히 달라집니다.모델은 구글이 최근 공개한 Gemma 4 E2B로 정했습니다.고성능 스마트폰에서도 돌아가도록 설계된 모델이니, 미니PC에서도 되지 않을까 싶었습니다. 결론부터

어둠의 모험 게임 플레이 화면, Lv.5 HP 128/148 미니맵 표시
로컬 LLM

Claude Code 로컬 LLM RTX 3060 12GB Qwen3.6 6분 만에 게임 1374줄

지난 글에서 Kimi K3와 Opus 5에 같은 프롬프트를 던져봤습니다.K3는 10분에 $0.70, Opus 5는 43분에 $14.90가 나왔죠. 그런데 그 글을 쓰면서 계속 걸리는 게 하나 있었습니다. 그럼 제 3060은요? K3는 2.8조 파라미터라 애초에 후보가 아닙니다.하지만 12GB 카드에 올릴 수 있는 모델 중에도 쓸 만한 게 있지 않을까 싶었습니다. 그래서 이번엔 Claude Code 로컬 LLM 연결에 도전해봤습니다.llama.cpp를

미니PC NAS로 사용할 ASUS PN40 미니PC에 전원과 랜선이 연결된 모습
홈서버

미니PC NAS 만들기 우분투 서버 Samba Tailscale 외부접속까지

이 블로그에서는 그동안 RTX 3060으로 로컬 LLM을 돌리는 글을 주로 썼는데 이번엔 방향이 좀 다릅니다.집에 굴러다니던 미니PC로 미니PC NAS를 만들어봤습니다. ASUS PN40, 셀러론 J4125에 램 8GB, SSD 128GB입니다.몇 년 전에 우분투를 깔아뒀는데 그 뒤로 켜본 적이 없습니다. 손바닥만 합니다. 소비전력도 10W 남짓이라 24시간 켜둬도 부담이 없습니다.미니PC NAS로 쓰기엔 오히려 이런 게 낫습니다. 이걸로 미니PC NAS를

Opus 5가 만든 잿빛 균열 PC 플레이 화면, 1막 속삭이는 숲
모델 비교

Kimi K3 vs Opus 5 게임 만들기 10분 $0.70 vs 43분 $14.90

이 블로그 첫 글에서 이렇게 썼습니다. “중국 쪽에서는 Kimi K3랑 GLM 5.2까지 나왔죠. K3도 곧 공개될 예정입니다. 오픈웨이트라는 건 모델 파일을 그냥 다운받을 수 있다는 뜻입니다. 즉, 이론상으로는 집에서 공짜로 돌릴 수 있다는 얘기죠. 집에 데이터센터가 있다면요.” 지금까지 이 블로그는 젬마4 12B, gpt-oss 20B, Qwen3.6 35B-A3B까지 RTX 3060 12GB에 올려봤습니다.그런데 K3는 2.8조 파라미터입니다. 3060으로는 죽어도

기본값 8스텝으로 생성한 눈밭의 흰 개 이미지
이미지 생성

RTX 3060 12GB Z-Image-Turbo 후기 스텝 4면 충분 22초

지난 글에서 RTX 3060 12GB로 로컬 이미지 생성을 해봤습니다.SDXL Turbo로 512×512 한 장 뽑는 데 4.35초, VRAM은 7.8GB만 썼죠. 4GB 넘게 남았으니 더 큰 것도 되지 않을까 싶었습니다. 그래서 이번엔 Z-Image-Turbo입니다. 다운로드 용량이 19GB인데 제 카드는 12GB입니다.될 리가 없어 보이는데, 파일 구성을 뜯어보니 얘기가 좀 달랐습니다. Z-Image-Turbo, 크기 19GB의 정체 ComfyUI 템플릿 목록에서 첫 번째

로컬 이미지 생성 SDXL Turbo가 영어 프롬프트로 생성한 눈밭에 앉은 흰색 진돗개 이미지
이미지 생성

RTX 3060 12GB 로컬 이미지 생성 후기 ComfyUI 설치방법

지금까지 이 블로그에서는 RTX 3060 12GB 위에젬마4 12B, gpt-oss 20B, Qwen3.6 35B-A3B까지 계속 올려봤습니다. 그런데 계속 궁금한 게 하나 있었습니다. 이 카드로 로컬 이미지 생성도 되나? 찾아보니 로컬 이미지 생성도 12GB면 충분히 된다는 얘기가 많더군요.그래서 이번엔 ComfyUI를 깔아봤습니다. 그리고 첫 이미지를 뽑다가 예상 못 한 걸 하나 발견했습니다! 바로 가시죠 로컬 이미지 생성 ComfyUI 설치

ollama pull 명령으로 Qwen3.6 35B-A3B 모델 23GB를 다운로드하는 PowerShell 화면
로컬 LLM

RTX 3060 12GB로 Qwen3.6 35B-A3B 후기 44 tok/s 컨텍스트 26만

지난 글에서 gpt-oss 20B를 RTX 3060 12GB에 올려봤습니다. 13GB짜리를 12GB 카드에 밀어넣었는데 46 tok/s가 나왔습니다.30%가 CPU로 밀려났는데도요. 그 글은 이렇게 끝냈습니다. “VRAM만 보고 포기했던 모델도, MoE라면 한 번쯤 시도해볼 가치가 있습니다.” 그렇다면?! 더 큰 모델도 가능하지않을까 싶어서 이렇게 글을 작성해봅니다! 13GB는 됐습니다. 그럼 그 다음은요? 그래서 이번엔 좀 더 크게 가봤습니다. Qwen3.6 35B-A3B입니다. 올해 4월에

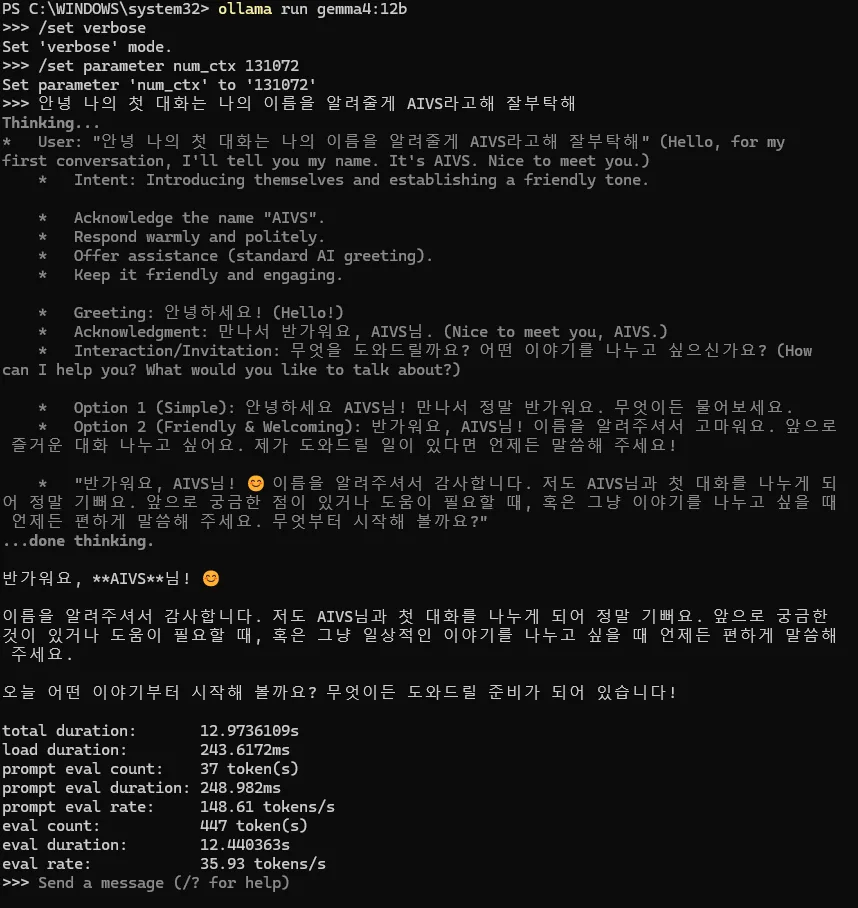
올라마 컨텍스트 131072 설정 후 첫 인사, prompt eval count 37 토큰
로컬 LLM

올라마 컨텍스트 128K RTX 3060 12GB 실측

지난 두 글에서 RTX 3060 12GB에 젬마4(Gemma 4) 12B와 gpt-oss 20B를 올려봤습니다. 둘 다 올라마 컨텍스트를 128K까지 늘리는 데 성공했습니다. 그런데 그 글들을 올리고 나서 계속 걸리는 게 하나 있었습니다. 저는 128K를 열어놓기만 했지, 한 번도 채워본 적이 없었습니다. 그때 제가 모델에게 물어본 건 “안녕? 네 이름은 뭐야” 였습니다. 13만 토큰짜리 그릇을 준비해놓고 숟가락 하나

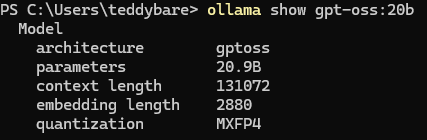
ollama show gpt-oss:20b 명령 결과로 아키텍처 gpt oss
로컬 LLM

RTX 3060 12GB gpt oss 20B 돌아갈까? 46 tok/s 컨텍스트 128K

지난 글에서 RTX 3060 12GB에 젬마4(Gemma 4) 12B를 올려서 테스트해봤습니다. 결과는 예상보다 좋았습니다. 컨텍스트 128K, 생성 속도 평균 36 tok/s로 아주 원활하게 사용 가능했습니다. 그런데 그 글을 쓰면서 계속 걸리는 게 하나 있었습니다. 모델이 VRAM 12GB 중 8.1GB만 썼다는 점입니다. 4GB 가까이 남았거든요. 남은 공간이 있으면 더 큰 모델도 되지 않을까 싶었습니다. 그래서 이번엔 욕심을

위로 스크롤