
지난 두 글에서 RTX 3060 12GB에 젬마4(Gemma 4) 12B와 gpt-oss 20B를 올려봤습니다.
둘 다 올라마 컨텍스트를 128K까지 늘리는 데 성공했습니다.
그런데 그 글들을 올리고 나서 계속 걸리는 게 하나 있었습니다.
저는 128K를 열어놓기만 했지, 한 번도 채워본 적이 없었습니다.
그때 제가 모델에게 물어본 건 “안녕? 네 이름은 뭐야” 였습니다.
13만 토큰짜리 그릇을 준비해놓고 숟가락 하나 담아본 셈이죠.
그래놓고 “13만까지 됩니다”라고 썼던 겁니다.
이번엔 진짜로 채워보겠습니다.
확인하고 싶은 것 3가지
지난 글들처럼 먼저 질문부터 정하고 시작하겠습니다.
첫번째, 채우면 VRAM이 늘어날까?
지난 글에서 올라마 컨텍스트를 32K에서 128K로 네 배 늘렸는데 VRAM이 100MB밖에 안 늘어서 놀랐습니다.
그런데 그건 자리만 잡아둔 상태였습니다. 실제로 채우면 늘어나는 게 아닐까요?
두번째, 채우면 느려질까?
지난 글의 36.33 tok/s는 빈 상태에서 인사말 하나 던지고 잰 값입니다.
10만 토큰을 넣은 상태에서도 그 속도가 나올까요?
세번째, 정말 다 기억할까?
128K를 다 채웠을 때 맨 처음 한 말을 기억하고 있을까요?
그리고 넘기면 어떻게 될까요?
올라마 컨텍스트 128K 설정하는 법
본격적으로 시작하기 전에, 설정부터 하고 가겠습니다.
/set parameter num_ctx 131072
num_ctx가 올라마 컨텍스트 크기를 정하는 값입니다. 131072는 128 × 1024, 즉 128K입니다.
/set verbose를 켜면 응답마다 상세 정보가 찍힙니다. 이번 글은 이 숫자들이 전부니까 꼭 켜셔야 합니다.
적용됐는지는 다른 창에서 확인합니다.
ollama ps
CONTEXT 칸이 131072면 성공입니다.
먼저 “안녕?”이 몇 토큰인지 봤습니다
지난 글에서 제가 뭘 놓쳤는지부터 확인해보겠습니다.
첫 인사를 건넸습니다.
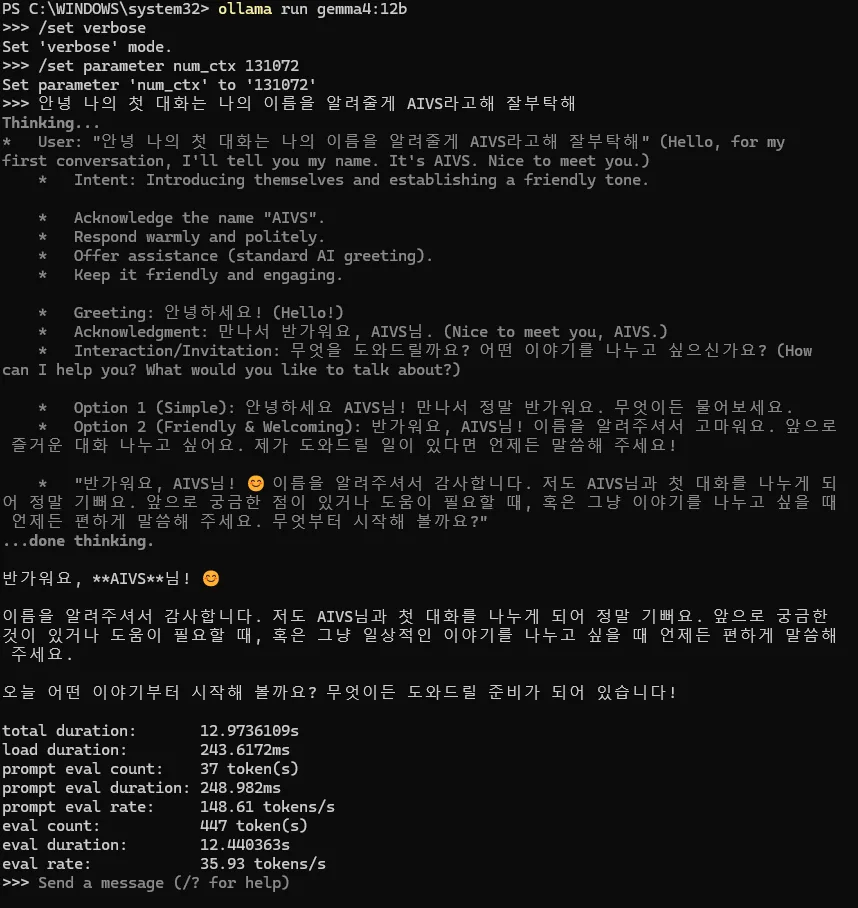
여기서 아래부분에 prompt eval count가 지금 올라마 컨텍스트에 담긴 토큰 수입니다. 37 token(s)
이 글 내내 이 숫자를 쫓아갈 겁니다.
37토큰.
13만 1072칸 중에 37칸을 썼습니다. 0.03%입니다.
지난 글에서 “컨텍스트 128K 통과”라고 썼던 그 순간의 실제 사용량이 이겁니다.
그리고 재밌는 게 하나 더 있습니다. 제가 보낸 건 37토큰인데 모델은 447토큰을 만들었습니다. 12배입니다.
화면을 보시면 답변은 몇 줄인데 Thinking... 구간이 훨씬 깁니다.
“Option 1, Option 2” 하면서 인사말 초안을 여러 번 고쳐 쓰고 있죠. 지난 글에서 봤던 그 습성 그대로입니다.
뭘 넣을지 정했습니다, 민법 전문
13만 토큰을 채우려면 아주 긴 문서가 필요합니다.
저는 대한민국 민법 전문을 골랐습니다. 이유가 세 가지입니다.
1. 저작권 걱정이 없습니다.
저작권법 제7조에 헌법·법률·조약·명령·조례·규칙은 보호받지 못하는 저작물로 명시돼 있습니다.
2. 누구나 똑같이 구할 수 있습니다. 국가법령정보센터(law.go.kr)에서 받으면 됩니다.
이 글을 읽고 따라 해보실 수 있다는 뜻입니다.
3. 채점이 됩니다. 조문 번호와 내용이 1:1로 대응하니까 모델이 지어내면 즉시 티가 납니다.
그런데 여기서 삽질을 했습니다
파일을 받아서 파워셸로 열었더니 이렇게 나왔습니다.
踰뺣졊
- 誘쇰쾿
踰뺤젣泥?援??踰뺣졊?뺣낫?쇳꽣
한글이 전부 깨졌습니다. 파일은 UTF-8인데 파워셸이 다른 인코딩으로 읽어서 생긴 문제였습니다.
이게 왜 중요하냐면, 깨진 상태로도 모델은 에러 없이 답을 합니다.
깨진 글자는 토크나이저가 못 알아봐서 바이트 단위로 쪼개집니다. 그래서 토큰을 훨씬 많이 먹습니다.
| 상태 | 글자당 토큰 |
|---|---|
| 깨진 상태 | 1.5 |
| 정상 | 0.681 |
두 배 넘게 차이납니다. 인코딩 하나 틀렸다고 올라마 컨텍스트를 두 배로 낭비하고 있었던 겁니다.
-Encoding UTF8을 붙여서 해결했고, 정상 비율인 0.681이 나왔습니다.
한국어는 글자당 약 0.68토큰입니다. 즉 128K = 한글 약 19만 자입니다. 단행본 한 권 정도죠.
첫번째, 올라마 컨텍스트를 채우면 VRAM이 늘어날까?
이제 민법을 붙여넣기 시작했습니다.
터미널에서 긴 글을 여러 줄로 넣으려면 """ 를 씁니다.
"""
[민법 텍스트 붙여넣기]
"""
한 뭉치씩 던지면서 prompt eval count가 올라가는 걸 지켜봤습니다.

6만 8천 토큰. 절반을 넘겼습니다.
여기서 다른 창을 열어 ollama ps로 VRAM을 확인했습니다.

8.2GB, 100% GPU.
지난 글에서 아무것도 안 넣고 쟀을 때와 완전히 같은 숫자입니다.
계속 채워봤습니다.
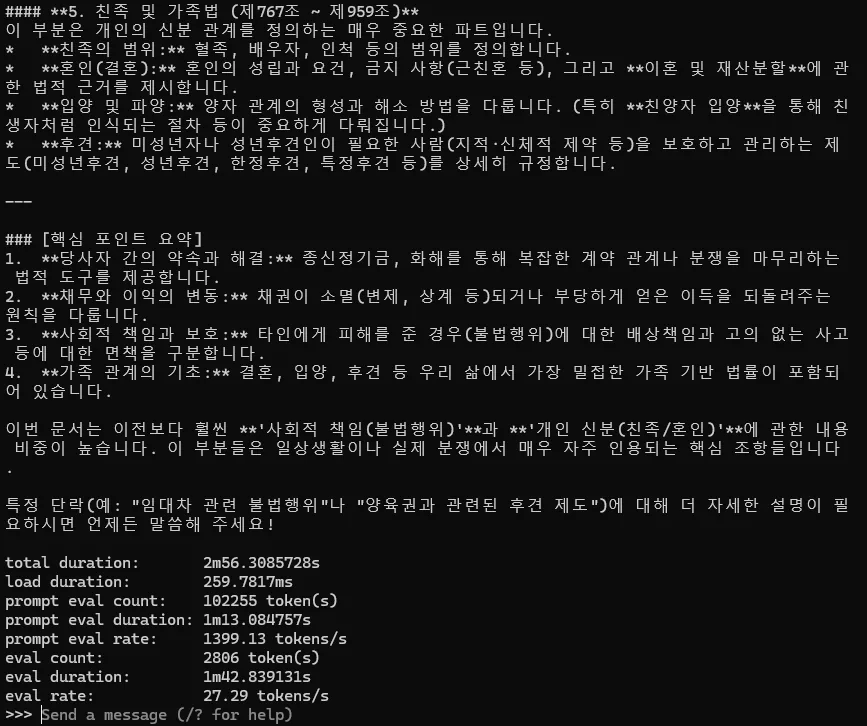
10만 2천 토큰. 78%를 채웠습니다.
다시 확인했습니다.
VRAM SIZE 8.2GB, 100% GPU 그대로였습니다.
| 컨텍스트 사용량 | 사용률 | SIZE | PROCESSOR |
|---|---|---|---|
| 37 토큰 | 0.03% | 8.2 GB | 100% GPU |
| 68,180 토큰 | 52% | 8.2 GB | 100% GPU |
| 102,255 토큰 | 78% | 8.2 GB | 100% GPU |
10만 토큰을 밀어넣었는데 소수점도 안 움직였습니다. CPU로 새지도 않았습니다.
왜 안 늘어날까
올라마는 모델을 VRAM에 올릴 때 num_ctx 값을 보고 13만 토큰짜리 자리를 미리 다 잡아둡니다.
그러니까 나중에 채워도 더 늘어날 게 없습니다. 자리는 이미 잡혀 있었으니까요.
첫번째 질문 답: 올라마 컨텍스트가 먹는 VRAM은 “설정값”이 정합니다. “내용”이 정하지 않습니다.
이건 실용적으로도 중요합니다. num_ctx를 필요 이상으로 크게 잡으면, 안 쓰는 자리를 계속 붙들고 있게 됩니다.
두번째, 그럼 공짜인가?
VRAM이 안 늘어나니 공짜인가 싶었는데, 아니었습니다.
위 스크린샷들의 eval rate를 다시 보겠습니다.
| 컨텍스트 사용량 | 생성 속도 |
|---|---|
| 37 토큰 | 35.93 tok/s |
| 45,805 토큰 | 30.84 tok/s |
| 68,180 토큰 | 29.39 tok/s |
| 102,255 토큰 | 27.29 tok/s |
35.93에서 27.29로. 24% 떨어졌습니다.
지난 두 글에서 속도가 떨어질 때마다 이유는 하나였습니다. CPU로 밀려났기 때문이었죠.
그런데 이번엔 아무것도 CPU로 안 밀렸습니다. 100% GPU 그대로입니다. VRAM도 8.2GB 그대로고요.
그런데도 24%를 잃었습니다.
이유는 다른 데 있었습니다.
모델이 토큰 하나를 만들 때마다 앞에 쌓인 10만 토큰을 전부 훑어야 합니다.
올라마 컨텍스트가 길수록 그 비용이 커집니다.
자리값은 고정인데 통행료가 계속 오르는 셈입니다.
두번째 질문 답: 공짜가 아닙니다. VRAM 대신 속도로 냅니다.
그런데 진짜 문제는 이게 아니었습니다
여기서 예상 못 한 걸 발견했습니다.
지난 두 글에서 제가 잰 tok/s는 전부 답이 나오기 시작한 다음의 속도였습니다.
그런데 긴 문서를 넣으면 그 전에 다른 구간이 있습니다.
prompt eval count:    102255 token(s)
prompt eval duration: 1m13.084757s    ← 이거
eval count:           2806 token(s)
eval duration:        1m42.839131s
prompt eval duration
모델이 입력을 다 읽는 시간입니다.
이 구간 동안 화면에는 아무것도 안 나옵니다. 커서만 깜빡입니다.
1분 13초.
민법 뭉치를 던지고 나서 1분 13초 동안 화면이 조용했습니다.
그 다음에야 Thinking...이 뜨고 글자가 나오기 시작했습니다.
| 넣은 것 | 입력 토큰 | 첫 글자가 나오기까지 |
|---|---|---|
| “안녕?” | 37 | 0.25초 |
| 블로그 1편 전문 | 3,929 | 3.5초 |
| 민법 일부 | 68,180 | 42.2초 |
| 민법 더 많이 | 102,255 | 73.1초 |
지난 글에서 “36 tok/s라 빠릅니다”라고 썼는데, 그건 답이 나오기 시작한 다음 이야기였습니다.
실제로 문서를 넣으면 사용자가 체감하는 건 그 앞의 침묵입니다.
그런데 읽는 속도는 오히려 빨라집니다
재밌는 건 방향이 반대라는 겁니다.
| 입력 토큰 | 읽는 속도 |
|---|---|
| 37 | 148.6 tok/s |
| 3,929 | 1,113.8 tok/s |
| 68,180 | 1,615.6 tok/s |
| 102,255 | 1,399.1 tok/s |
짧은 입력은 GPU를 제대로 못 채워서 손해입니다. 몇만 토큰쯤 되어야 제대로 속도가 나옵니다.
읽기는 뭉텅이 작업이라 규모의 이득을 보고, 생성은 낱개 작업이라 누적 부담을 집니다.
다만 속도가 빨라져도 양이 워낙 많으니 절대 시간은 계속 늘어납니다.
세번째, 올라마 컨텍스트는 정말 다 기억할까?
이제 본론입니다.
첫 대화에서 제 이름을 알려줬습니다. 그리고 민법을 6만 8천 토큰까지 밀어넣었습니다.
기억하고 있을까요?
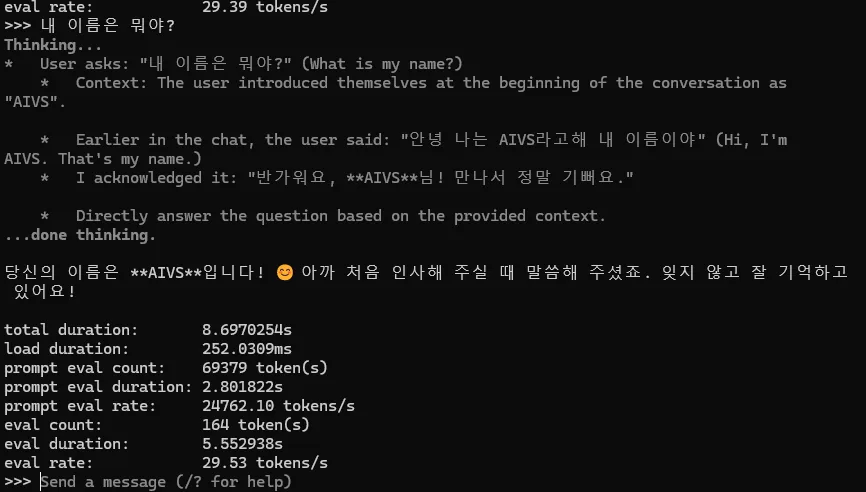
정확히 맞혔습니다.
그냥 맞힌 게 아니라 Thinking... 구간에서 제가 한 말을 원문 그대로 인용하고 있습니다.
6만 9천 토큰 뒤에서도 맨 앞의 문장이 그대로 살아 있다는 뜻입니다.
여기서 또 하나 눈에 띄는 게 있습니다.
prompt eval count:    69379 token(s)
prompt eval duration: 2.801822s
6만 9천 토큰인데 2.8초 만에 답이 나왔습니다. 아까 6만 8천 토큰을 넣을 때는 42초가 걸렸는데요.
이미 읽어둔 건 다시 안 읽습니다. 캐시에 남아 있거든요.
즉 긴 문서는 처음 한 번만 비쌉니다. 한 번 넣어두면 그 뒤 대화는 빠릅니다. 매번 1분씩 기다리는 게 아닙니다.
그런데 여기서 실수를 했습니다
53% 지점에서 이름을 물어본 게 문제였습니다.
제가 물어본 그 대화도 올라마 컨텍스트에 쌓입니다.
답변에 “AIVS”가 또 등장했으니, 이름이 두 번 기록된 셈이죠.
이러면 나중에 넘쳐서 맨 앞이 밀려나도 53% 지점의 두 번째 기록이 남아서 여전히 기억할 수 있습니다.
깨끗한 테스트가 안 됩니다.
그래서 /clear로 대화를 전부 지우고 처음부터 다시 했습니다.

이번엔 이름에 검증코드까지 붙였습니다. 그리고 중간에 절대 물어보지 않기로 했습니다.
민법만 계속 던지면서 prompt eval count가 올라가는 것만 지켜봤습니다.
그리고 올라마 컨텍스트가 넘쳤습니다
95,863토큰까지 채웠습니다. 73%입니다.
여기서 민법을 큰 뭉치로 하나 더 던졌습니다.
저는 숫자가 131,072에서 멈출 거라고 예상했습니다.
창 크기가 131,072니까요.
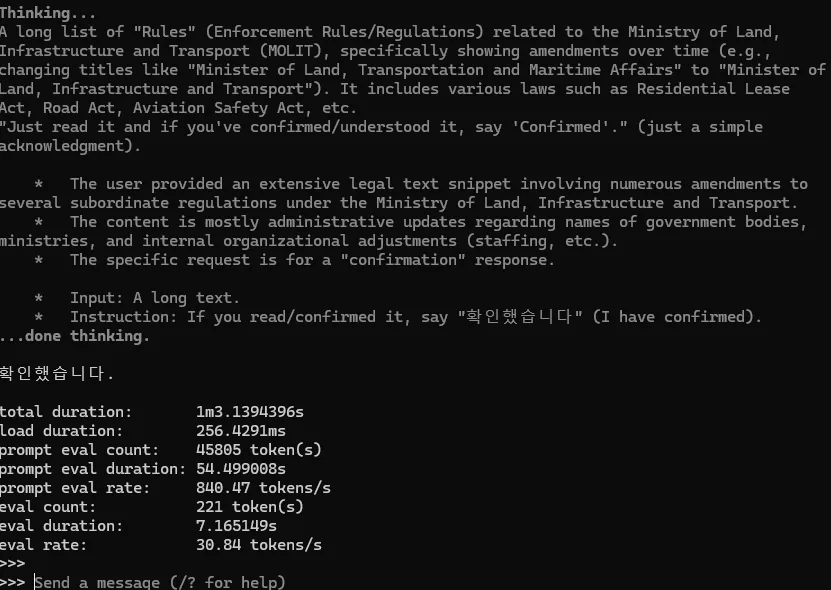
45,805.
95,863에서 줄었습니다.
에러도 없었습니다. 경고도 없었습니다.
그냥 숫자가 줄어 있었습니다.
정확한 동작은 확인하지 못했습니다.
다만 131,072를 넘긴 만큼 앞부분이 밀려나고, 초과분이 다시 채워진 것으로 보입니다.
그리고 여기서 손해가 하나 더 있습니다.
prompt eval duration: 54.499008s
45,805토큰을 54초 걸려 다시 읽었습니다. 앞부분이 잘려나가면서 캐시가 무효화됐기 때문입니다.
넘치면 두 번 손해입니다. 앞부분을 잃고, 남은 것도 다시 읽어야 합니다.
그래서 물어봤습니다
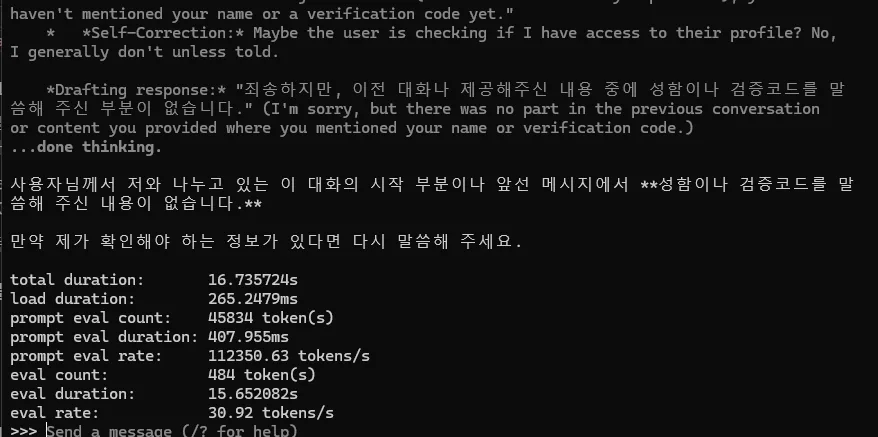
내 이름이랑 검증코드가 뭐였지?? 알려준적이 없답니다!!
대화 맨 처음에 분명히 알려줬습니다. 첫 메시지가 그거였습니다.
모델은 지어내지도 않았고, 헷갈려하지도 않았습니다. 그냥 없는 겁니다.
Thinking... 구간을 보시면 명확합니다.
아까 53% 지점에서는 Earlier in the chat, the user said: "안녕 나는 AIVS라고해" 하면서 원문을 인용했었죠.
이번엔 그 인용이 아예 없습니다. 찾을 게 없으니까요.
결론
첫번째, 컨텍스트를 채우면 VRAM이 늘어날까? 안 늘어납니다.
37토큰일 때 8.2GB, 10만 토큰일 때도 8.2GB. 100% GPU 그대로입니다.
두번째, 채우면 느려질까? 느려집니다. 35.93에서 27.29로.
세번째, 정말 다 기억할까? 한계 안에서는 완벽하게. 넘어가면 잃습니다.
좋았던 것
- 10만 토큰을 넣어도 VRAM이 8.2GB 그대로입니다. 12GB 카드에서 여유롭습니다
- CPU로 한 조각도 안 샜습니다. 끝까지 100% GPU였습니다
- 6만 9천 토큰 뒤에서도 첫 문장을 원문 그대로 인용했습니다. 기억력은 확실합니다
- 한 번 읽어둔 문서는 다시 안 읽습니다. 6만 9천 토큰인데 2.8초 만에 답이 나왔습니다
아쉬운 것
- 생성 속도가 24% 떨어집니다. 36 tok/s는 빈 컨텍스트에서만 나오는 숫자였습니다
- 10만 토큰을 넣으면 답이 나오기까지 1분 13초를 기다려야 합니다
- 넘치면 아무 경고 없이 앞에서부터 사라집니다
지난 글에서 이렇게 썼습니다
“컨텍스트 13만 토큰. 문서 몇 개는 통째로 넣고 대화할 수 있습니다”
틀린 말은 아니었습니다. 다만 그때 제가 실제로 넣은 건 “안녕? 네 이름은 뭐야” 한 마디였습니다.
37토큰. 13만 칸 중 0.03%.
그릇을 13만짜리로 키워놓고 숟가락 하나 담아본 다음, “13만까지 됩니다”라고 썼던 겁니다.
이번에 진짜로 담아보니 두 가지가 달랐습니다.
하나, 담는 데 시간이 걸립니다.
지난 글 내내 “36 tok/s라 빠릅니다”라고 자랑했는데, 그건 답이 나오기 시작한 다음 이야기였습니다.
정작 사용자가 기다리는 건 그 앞의 1분 13초였습니다.
둘, 그릇에는 바닥이 있습니다. 그리고 넘칠 때 알려주지 않습니다.
그래서 결론은
컨텍스트를 채워도 VRAM은 안 늘어납니다. 대신 속도가 떨어집니다.
그리고 한계를 넘으면 앞부분이 사라집니다.
올라마는 에러를 내지 않습니다. 경고도 없습니다. 그냥 조용히 앞에서부터 버립니다.
사용자 입장에서는 모델이 갑자기 깜빡한 것처럼 보일 뿐입니다.
긴 문서를 다루실 거라면 prompt eval count를 꼭 보세요.
이 숫자가 올라가다가 어느 순간 줄었다면, 앞부분을 버린 겁니다.
올라마 GUI에도, ollama ps에도 이걸 알려주는 표시는 없습니다.
ollama ps의 CONTEXT 칸은 “열어둔 크기”지 “채운 양”이 아닙니다. “안녕”만 쳐도 131072로 나옵니다.
그래도 몇 년 전에 게임 하려고 산 그래픽카드 한 장으로 13만 토큰짜리 대화를 GPU만으로 돌린다는 게 너무 신기하지 않나요?
VRAM 8.2GB로 책 한 권 분량을 통째로 읽히고 질문할 수 있으니까요.
다만 그 13만 컨텍스트가 무한대는 아니라는 것!
그리고 그 끝에는 경고가 없다는 것! 그 정도는 알고 쓰는 게 좋겠습니다.