
지난 글에서 gpt-oss 20B를 RTX 3060 12GB에 올려봤습니다.
13GB짜리를 12GB 카드에 밀어넣었는데 46 tok/s가 나왔습니다.
30%가 CPU로 밀려났는데도요.
그 글은 이렇게 끝냈습니다.
“VRAM만 보고 포기했던 모델도, MoE라면 한 번쯤 시도해볼 가치가 있습니다.”
그렇다면?! 더 큰 모델도 가능하지않을까 싶어서 이렇게 글을 작성해봅니다!
13GB는 됐습니다. 그럼 그 다음은요?
그래서 이번엔 좀 더 크게 가봤습니다. Qwen3.6 35B-A3B입니다.
올해 4월에 나온 모델이고, 올라마 공식 페이지에 24GB로 표시되어 있습니다.
Q4_K_M 양자화 기준입니다.
제 그래픽카드가 12GB니까 거의 두 배입니다.
참고로 Qwen3.6 35B 모델 공식 문서에서 권장하는 카드는 RTX 5090 32GB이고
거기서 초당 120토큰이 나온다고 합니다. 제가 쓰는 GPU는 3060 12GB입니다.
그런데 Qwen3.6 35B 모델도 MoE입니다.
지난 글의 gpt-oss 20B와 같은 구조죠.
메타데이터를 뜯어보면 숫자가 나옵니다.
전문가가 256개 있는데, 질문 하나에 그중 8개만 깨어납니다.
256개 중 8개. 3%가 조금 넘습니다.
지난번에 13GB짜리를 12GB 카드에 올리고도 46 tok/s가 나온 게 이 구조 덕분이었습니다.
그럼 23GB도 같은 일이 벌어질까요.
그래도 돌아가긴 돌아갈지! 한번 직접 테스트를 해보도록합시다.
기준 하나를 뺐습니다
지난 세 편에서 계속 같은 기준 3개를 썼습니다.
- 100% GPU로 돌아갈 것
- 생성 속도 20 tok/s 이상
- 컨텍스트를 어디까지 늘릴 수 있는가
그런데 지난 글에서 1번 기준이 의미가 없어졌습니다.
gpt-oss 20B는 30%가 CPU에 있었습니다.
1번 기준으로는 탈락입니다.
그런데 속도가 46.19 tok/s였습니다.
100% GPU로 돌던 젬마4 12B가 36.33이었으니, 기준을 못 넘긴 쪽이 27% 더 빨랐던 겁니다.
생각해보면 100% GPU를 조건으로 걸었던 이유는 하나였습니다.
CPU로 넘어가면 느려지니까요.
그런데 MoE는 안 느려집니다. 밀려난 부분이 매번 쓰이는 게 아니니까요.
Dense 모델을 기준으로 만든 조건을, MoE 모델에 그대로 들이대고 있었던 거죠.
그래서 이번 글에서는 아예 뺐습니다.
첫번째, 생성 속도 20 tok/s 이상 두번째, 컨텍스트를 어디까지 늘릴 수 있는가
이 두개를 기준으로 잡겠습니다.
지난 글들이랑 똑같이 두도록하겠습니다.
조건이 달라지면 비교가 안 되니까요.
Qwen3.6 35B(23GB)를 VRAM 12GB에 밀어넣기
먼저 간단하게 계산부터 해보죠.
- 모델 파일 23GB
- 제 VRAM 12GB
- 모자란 만큼 11GB
이 11GB가 시스템 램으로 갑니다. 제 PC 램은 DDR5 4800 32GB입니다.
지금까지는 램을 신경 쓴 적이 없었습니다.
7.4GB, 13GB짜리는 VRAM 근처에서 다 해결됐거든요.
이번 Qwen3.6 35B 모델은 다릅니다.
혹시나해서 브라우저까지 전부 닫고 시작했습니다.

시작 전 램 사용량은 10.6GB였습니다. 32GB 중 34%. 사용 가능한 게 21GB 남아 있었습니다.
모델 받기
명령어는 한 줄이면 됩니다.
ollama pull qwen3.6:35b-a3b

올라마 웹페이지에는 Qwen3.6 35B 모델은 24GB로 나오는데 실제로는 23GB로 찍히긴합니다.
첫 글의 젬마4가 7.4GB였으니 세 배가 넘습니다.
다운 속도가 11MB/s 나왔고, 다 받는 데 30분 넘게 걸렸습니다.
일단 켜봅니다
ollama run qwen3.6:35b-a3b

대화는 잘 작동합니다.
23GB짜리가 12GB 카드에서 돌아간다는 게 이상하죠?
램 사용량을 다시 봤습니다.
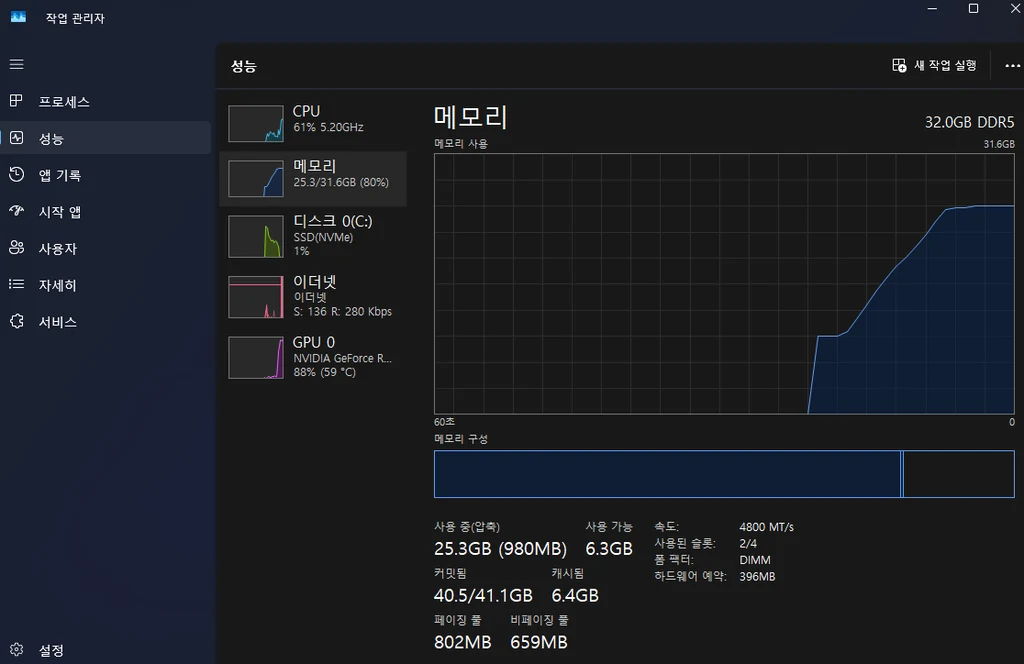
25.3GB로 올라갔습니다. 80%입니다.
10.6GB에서 25.3GB로, 14.7GB가 늘었습니다.
이 램 사용량은 마지막에 다시 보겠습니다.
얼마나 밀려났나
ollama ps
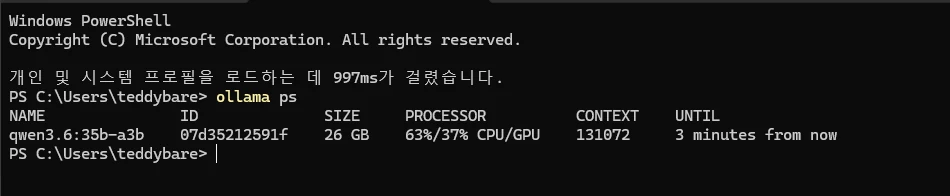
63%가 CPU로 갔습니다.
지금까지 작성했던 글과 비교해보면 아래와 같습니다.
| 모델 | CPU 비율 |
|---|---|
| 젬마4 12B | 0% |
| 젬마4 12B (256K) | 29% |
| gpt-oss 20B | 30% |
| Qwen3.6 35B | 63% |
작성했던 글 중에 cpu로 넘어간 비율이 가장 높네요.
모델의 절반 이상이 그래픽카드 밖에 있습니다.
하지만 문제없습니다. MoE니까요.
첫번째, 속도는 얼마나 나오나
지난 글과 똑같은 방법으로 쟀습니다. 조건이 달라지면 비교가 안 되니까요.
/set verbose를 켜고, 질문은 “안녕?”으로 통일, /clear로 기록을 지우면서 다섯 번.
컨텍스트는 건드리지 않았습니다. 아까 본 기본값 128K 그대로입니다.

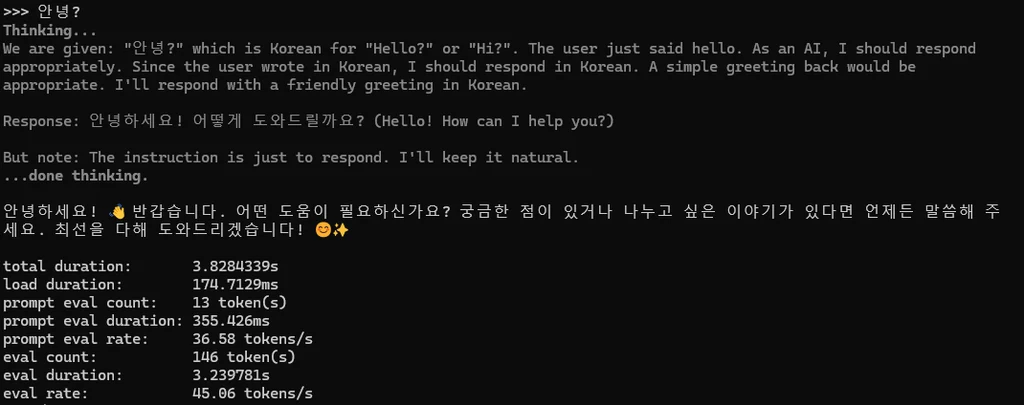
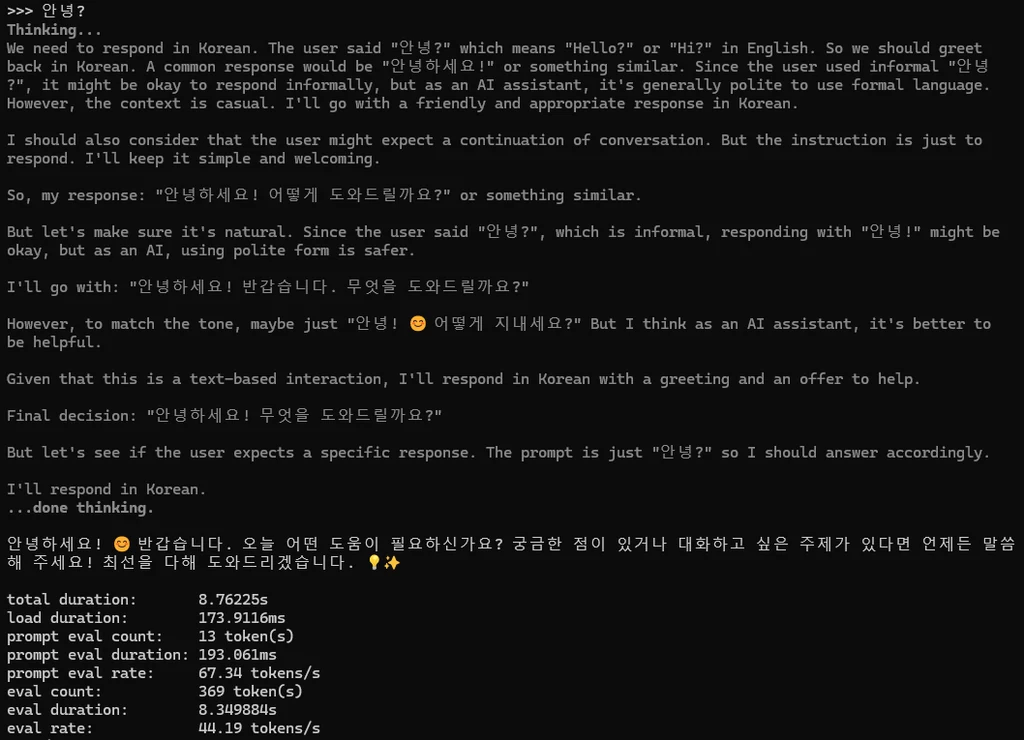
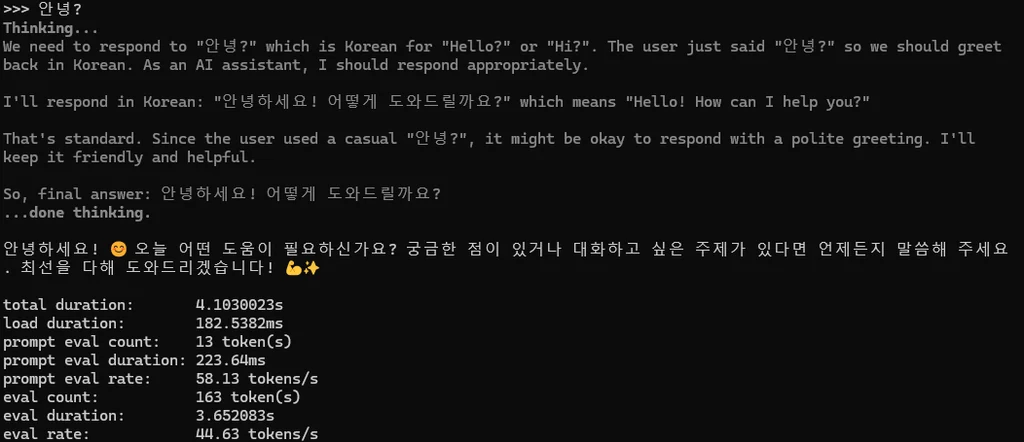
| 회차 | 생성 속도 | 출력 토큰 | 총 소요 |
|---|---|---|---|
| 1회차 | 41.88 tok/s | 211 | 6.91초 |
| 2회차 | 45.31 tok/s | 232 | 5.58초 |
| 3회차 | 45.06 tok/s | 146 | 3.83초 |
| 4회차 | 44.19 tok/s | 369 | 8.76초 |
| 5회차 | 44.63 tok/s | 163 | 4.10초 |
| 평균 | 44.21 tok/s | 224 | 5.84초 |
평균 44.21 tok/s입니다. 128K 컨텍스트에서요.
gpt-oss 20B가 46.19였습니다. 거의 같습니다.
모델은 13GB에서 23GB로 늘었습니다. CPU로 밀려난 비율은 30%에서 63%로 두 배가 됐고요.
그런데 속도는 그대로입니다.
왜 안 느려졌을까
숫자 하나만 보면 됩니다.
| 모델 | 총 파라미터 | 매번 쓰이는 파라미터 |
|---|---|---|
| 젬마4 12B | 12B | 12B (전부) |
| gpt-oss 20B | 21B | 3.6B |
| Qwen3.6 35B-A3B | 35B | 3B |
모델 이름에 붙은 A3B가 그 뜻입니다. Active 3B, 매번 30억 개만 깨어난다는 겁니다.
35B는 20B보다 총량이 1.7배 큽니다.
그런데 매번 깨어나는 양은 오히려 적습니다.
램에 밀려난 게 14GB쯤 되는데, 그 대부분은 이번 질문에 안 쓰이는 전문가들입니다.
256명 중 248명은 쉬고있는거죠.
| gpt-oss 20B | Qwen3.6 35B | |
|---|---|---|
| 생성 속도 | 46.19 tok/s | 44.21 tok/s |
| 출력 토큰 | 87개 | 224개 |
| 실제 기다린 시간 | 2.24초 | 5.84초 |
다만 이 모델은 답하기 전에 생각을 오래 합니다.
출력 토큰이 224개로 gpt-oss(87개)의 2.6배라 한 마디 물어보고 평균 5.84초를 기다려야 합니다.
그래도 첫번째 기준은 통과입니다. 합격선이 20 tok/s였으니까요.
두번째, 컨텍스트는 어디까지?
이 모델의 컨텍스트 스펙은 262,144입니다. 256K죠.
기본값이 이미 128K였으니, 남은 건 최대치까지 올려보는 것뿐입니다.
/set parameter num_ctx 262144

값을 바꾸면 모델이 통째로 다시 올라갑니다. 22.34초 걸렸습니다.
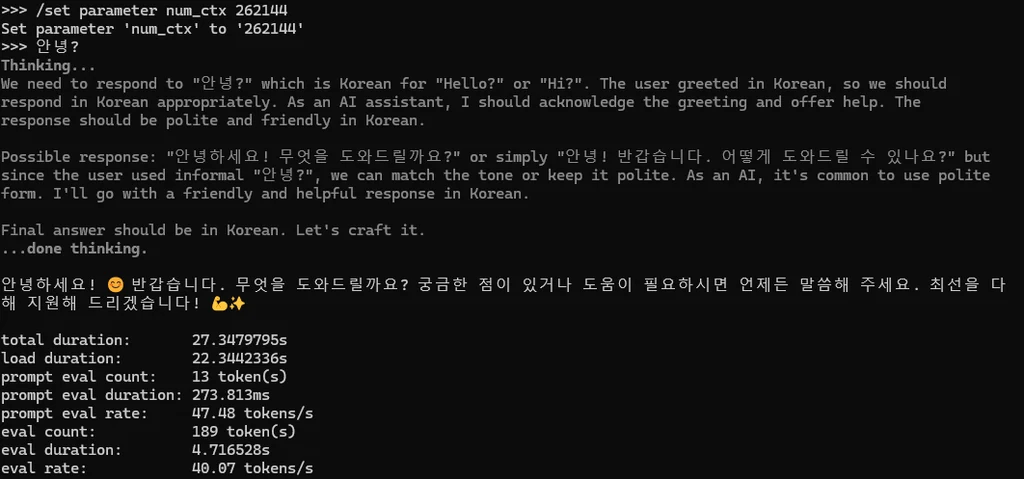
결과입니다.
| 컨텍스트 | 메모리 점유 | CPU/GPU | 속도 |
|---|---|---|---|
| 128K (기본값) | 26GB | 63% / 37% | 44.21 tok/s |
| 256K (최대) | 29GB | 66% / 34% | 40.07 tok/s |
돌아갑니다.
컨텍스트를 두 배로 늘렸는데 속도는 9% 떨어졌습니다. 44.21에서 40.07로요.
메모리 점유는 26GB에서 29GB가 됐습니다. 3GB 늘어난 게 대화 내용을 담아두는 공간입니다.
두번째 기준도 통과입니다. 그것도 스펙 최대치로요.
여기서 젬마4 글이 생각나네요.
젬마4 12B도 스펙이 256K였습니다. 그래서 최대치까지 올려봤었죠.
그런데 29%가 CPU로 밀려나면서 속도가 36.33에서 18.77로 반토막났습니다.
제가 정한 합격선 20 tok/s 밑이라 거기서 탈락했습니다.
같은 256K인데 이번엔 이렇습니다.
| 256K에서 | 모델 크기 | 속도 |
|---|---|---|
| 젬마4 12B | 7.4GB | 18.77 tok/s |
| Qwen3.6 35B | 23GB | 40.07 tok/s |
세 배 큰 모델이 두 배 넘게 빠릅니다.
젬마4는 29%만 밀려나고도 반토막이 났고, 이쪽은 66%가 밀려났는데 9%만 잃었습니다.
Dense와 MoE의 차이가 여기서 제일 크게 벌어집니다.
그리고 128K 지점에서는 지난 글과 직접 비교됩니다.
gpt-oss 20B는 128K에서 36.94 tok/s였습니다.
다만 그건 128K까지 억지로 끌어올린 결과였고
기본값 32K에서는 46.19였죠.
이번 모델은 128K가 기본값인데 44.21 tok/s입니다.
더 큰 모델이, 두 배 넓은 컨텍스트에서, 더 빠릅니다. (moe 모델이라서 가능!)
결론: 기준 2개 중 2개 통과
- 첫번째, 20 tok/s 이상 → 44.21 tok/s, 통과
- 두번째, 컨텍스트 한계 → 256K, 스펙 최대치까지 통과
정리하면 이렇습니다.
| 항목 | 결과 |
|---|---|
| 모델 크기 | 23GB |
| CPU 오프로드 | 63% (128K) / 66% (256K) |
| 생성 속도 | 44.21 tok/s (128K) |
| 생성 속도 | 40.07 tok/s (256K) |
| 컨텍스트 | 256K (스펙 최대) |
| 로딩 시간 | 22.34초 |
미뤄뒀던 램 사용량 다루겠습니다.

| 모델 올리기 전 | 128K | 256K | |
|---|---|---|---|
| 사용 중 | 10.6GB (34%) | 25.3GB (80%) | 28.3GB (90%) |
| 사용 가능 | 21.0GB | 6.3GB | 3.3GB |
| 커밋됨 | 13.1 / 35.0GB | 40.5 / 41.1GB | 43.2 / 44.3GB |
모델을 올리지않은 10.6GB에서 시작해 128k부터 256k 까지 25.3GB, 28.3GB로 올라갑니다.
컨텍스트를 두 배로 늘리면 램을 3GB 더 씁니다.
커밋 한도가 35GB에서 41GB로, 다시 44.3GB로 늘어났습니다.
램만으로 감당이 안 되니까 윈도우가 페이지파일을 계속 키운 겁니다.
그리고 그 한도의 97~98%를 쓰고 있습니다. 128K에서도 256K에서도요.
128k에서 남은 램은 6.3GB, 그리고 256k 에서는 3.3GB
(작업관리자, ollama 터미널 말고는 아무것도 없는 상태)
램 32GB로 되긴 됩니다. 다만 여유는 없습니다.
지금까지 작성했던 글은 모두 VRAM 이야기였습니다.
3060 12GB VRAM 안에 들어가는가?
그런데 이번 글에서 처음으로 VRAM이 아니라 램이 걸림돌이 됐습니다.
다음에 더 큰 모델이 나오면 그래픽카드가 아니라 램 때문에 못 돌리겠네요.
요즘 램 값이 치솟는 이유도 이것때문이지 않을까 싶네요
좋았던 것
- 23GB 모델이 12GB 카드에서 돌아갑니다. 카드 용량의 두 배입니다
- 128K에서 44.21 tok/s. 읽는 속도보다 훨씬 빠릅니다
- 컨텍스트 256K. 스펙 최대치를 다 썼습니다
- 66%가 밀려난 상태에서도 40 tok/s를 유지합니다
- 공식 권장이 5090 32GB인 모델을 3060으로 돌렸습니다
아쉬운 것
- 켜는 데 22초 걸립니다
- 답하기 전에 생각을 오래 합니다. 한 마디 물어도 평균 5.84초
- 램 32GB는 사실상 필수입니다. 그것도 여유 없이 딱 맞습니다
- 256K에서는 다른 프로그램 켜기 힘듭니다
그래서 결론은
먼저 제 컴퓨터 사양입니다.
| 부품 | 사양 |
|---|---|
| GPU | RTX 3060 12GB |
| CPU | 라이젠 9600X |
| 램 | DDR5 4800 32GB |
| 저장장치 | SSD 1TB |
평범한 조립 PC입니다.
이 사양에서 23GB 모델이 돌아갑니다.
기본값 128K에서 44 tok/s, 최대 256K에서 40 tok/s입니다.
기준 두 개 다 통과했고, 그중 하나는 스펙 최대치까지 갔습니다.
조건은 하나입니다. MoE여야 합니다.
첫 글의 젬마4는 cpu로 29% 밀려났을 때 속도가 반토막 났습니다.
Dense였으니까요.
이번 모델은 66%가 밀려났는데 9%만 잃었습니다.
같은 3060 12GB, 같은 256K인데 결과가 이렇게 다릅니다.
그럼 원활하게 쓸 만한가
솔직하게 나누면 이렇습니다.
원활합니다
- 문서 요약, 번역, 코드 몇 줄 물어보기
- 켜놓고 하루 종일 쓰는 용도
- 긴 문서 한두 개 넣고 이어서 대화하기
44 tok/s면 읽는 속도보다 훨씬 빠릅니다. 답이 나오기 시작하면 기다릴 일이 없습니다.
답답합니다
- 짧은 질문을 툭툭 던지는 용도
- 다른 프로그램 켜놓고 같이 쓰기
- 자주 껐다 켜는 용도
“안녕?” 한 마디에 평균 5.84초 걸립니다.
생각을 오래 하거든요. 짧게 여러 번 물어보는 식이면 계속 기다리게 됩니다.
그리고 램이 25~28GB까지 올라가니 램 여유가 없긴합니다.
모델 키는것도 22초정도 걸려서 좀 오래걸리는 편이구요
즉 이 모델은 “띄워놓고 쓰는” 용도입니다.
아침에 한 번 켜서 하루 종일 두고 쓰는 식이면 아주 쓸 만하고
필요할 때만 잠깐 켜는 식이면 젬마4 12B 쪽이 낫습니다.
7.4GB에 100% GPU라 가볍거든요.
32GB에서 커밋 메모리가 97%까지 찼습니다.
16GB로는 페이지파일을 심하게 긁어서 제 결과가 안 나올듯 합니다!
3060 12GB로도 35B 급 모델을 올려서 원활하게 사용 가능합니다!
공식 문서는 5090 32GB에서 초당 120토큰이 나온다고 했습니다.
제 3060 12GB에서는 44토큰입니다!
긴 글 읽어주셔서 감사합니다