
지난 글에서 RTX 3060 12GB에 젬마4(Gemma 4) 12B를 올려서 테스트해봤습니다.
결과는 예상보다 좋았습니다. 컨텍스트 128K, 생성 속도 평균 36 tok/s로 아주 원활하게 사용 가능했습니다.
그런데 그 글을 쓰면서 계속 걸리는 게 하나 있었습니다.
모델이 VRAM 12GB 중 8.1GB만 썼다는 점입니다. 4GB 가까이 남았거든요.
남은 공간이 있으면 더 큰 모델도 되지 않을까 싶었습니다.
그래서 이번엔 욕심을 좀 내봤습니다. gpt oss 20B입니다. GPT OSS, gpt oss로도 표기합니다.
파라미터가 20B니까 12B보다 훨씬 큽니다. 모델 파일만 13GB라 제 그래픽카드 12GB를 애초에 넘습니다.
상식적으로는 안 됩니다.
그런데 이 모델은 MoE라는 구조를 씁니다.
20B가 통째로 계산에 쓰이는 게 아니라, 질문 하나마다 일부만 깨어나는 방식입니다.
그럼 넘치더라도 덜 손해보지 않을까요?
합격 기준 3개
지난 글에서 정한 기준을 그대로 씁니다. 조건이 같아야 두 모델을 비교할 수 있으니까요.
첫번째, 100% GPU로 돌아갈 것
모델이 VRAM에 다 안 들어가면 나머지가 CPU로 넘어갑니다. 이러면 속도가 급격히 느려집니다.
두번째, 생성 속도 20 tok/s 이상
사람이 눈으로 읽는 속도보다 빨라야 답답하지 않습니다.
세번째, 컨텍스트를 어디까지 늘릴 수 있는가
컨텍스트가 넓어야 긴 문서를 넣거나 오래 대화할 수 있는데, 이게 전부 VRAM을 잡아먹습니다.
셋 다 통과하면 원활한 거고, 아니면 아닌 겁니다.
다만 이번엔 시작부터 불리합니다. 모델이 13GB인데 카드는 12GB니까요.
컨텍스트 관련한 실험 글도 있으니 참고해주세요!
→ 올라마 컨텍스트 128K RTX 3060 12GB 실측
모델 설치
올라마(Ollama)는 지난 글에서 이미 설치해뒀습니다.
아직 설치 전이시라면 PowerShell에 irm https://ollama.com/install.ps1 | iex 한 줄이면 끝납니다.
모델 설치도 명령어 하나입니다.
ollama pull gpt-oss:20b

그런데 다운로드가 시작되자마자 숫자가 눈에 들어옵니다. 13GB입니다.
지난번 젬마4(Gemma 4)는 7.4GB였습니다. 대략 두 배입니다.
제 그래픽카드는 12GB. 모델 파일만으로 이미 1GB를 넘겼습니다.
여기에 컨텍스트 캐시까지 얹어야 하니, 산수로는 답이 안 나옵니다.
그래도 일단 gpt oss 모델 받아서 대화를 시도해보겠습니다.
대화 시작
ollama run gpt-oss:20b
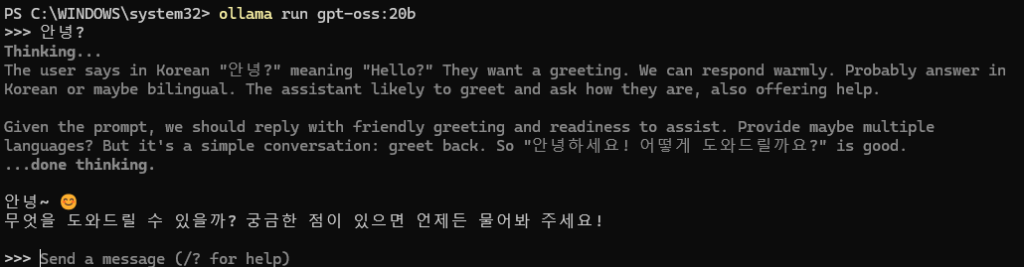
보시는 것처럼 gpt oss 대화 자체는 됩니다.
그런데 13GB짜리를 12GB 카드에 밀어넣었는데 멀쩡히 돌아간다는 게 이상하죠. 어딘가는 분명 새고 있을 겁니다.
모델이 GPU에 다 올라갔는지 확인하는 ollama ps 명령어를 입력해보겠습니다.
첫번째, 30%가 CPU로 밀렸는데 괜찮을까
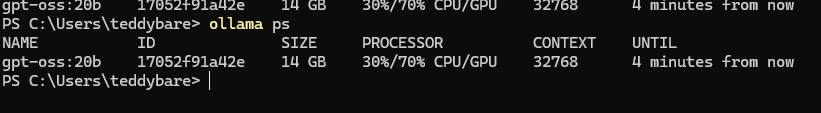
보시는 것처럼 100% GPU가 아니라 30%는 CPU로 할당된 것을 볼 수 있습니다.
그리고 SIZE가 14GB입니다. 받을 땐 13GB였는데 1GB가 늘었습니다.
대화 내용을 기억해두는 캐시가 얹혀서 그렇습니다.
첫번째 기준은 여기서 끝났습니다. 불합격이죠!
그런데 이 30%라는 숫자, 지난 글에서 본 적이 있습니다.
젬마4(Gemma 4)의 컨텍스트를 최대치까지 늘렸을 때 29%가 CPU로 밀려났고, 속도는 36 tok/s에서 18 tok/s로 정확히 반토막 났습니다. 30%만 넘겼는데 절반을 잃은 거죠.
이번엔 30%입니다. 거의 같은 조건입니다.
그렇다면 이번에도 반토막이 나야 정상입니다. 젬마4가 36에서 18이 됐으니, 이쪽도 그 정도로 떨어지겠죠.
그런데 gpt oss는 MoE입니다. 20B가 통째로 계산되는 게 아니라 질문마다 일부만 깨어납니다.
CPU로 밀려난 30%가 매번 쓰이는 부분이 아니라면, 손해도 덜하지 않을까요?
재봐야 알겠습니다.
두번째, 속도는 얼마나 나오나
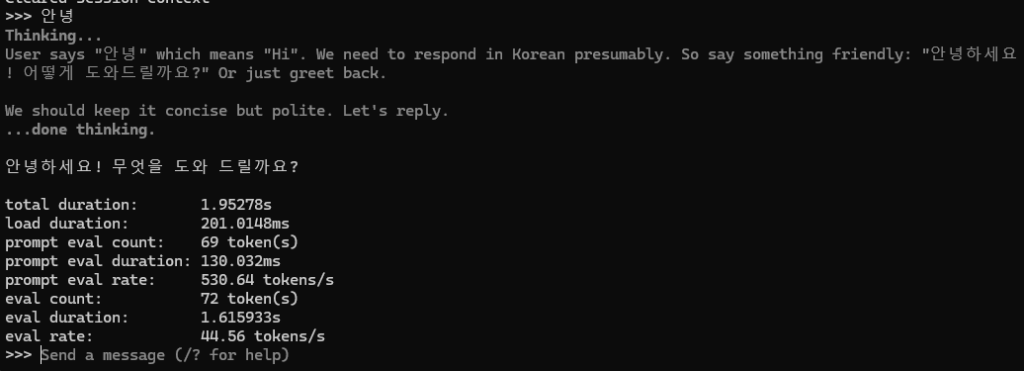
/set verbose를 켜면 응답마다 속도가 찍힙니다.
gpt oss한테 하는 질문은 “안녕”으로 통일했고, /clear로 대화 기록을 지우면서 3번 측정했습니다.
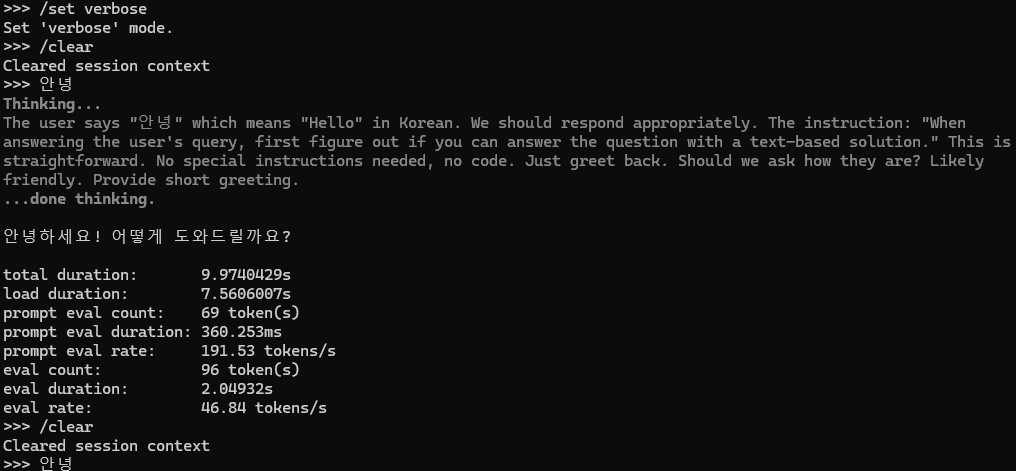
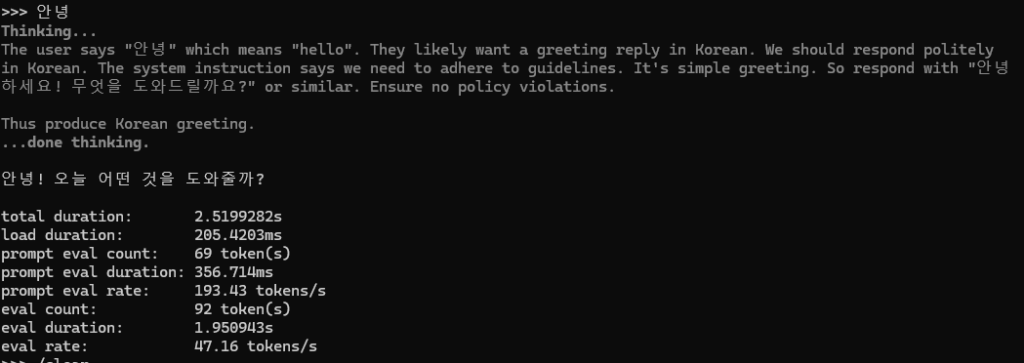
| 회차 | 생성 속도 | 출력 토큰 | 총 소요 |
| 1회차 | 46.84 tok/s | 96 | 9.97초 |
| 2회차 | 47.16 tok/s | 92 | 2.52초 |
| 3회차 | 44.56 tok/s | 72 | 1.95초 |
| 평균 | 46.19 tok/s | 87 | 2.24초 |
1회차 총 소요가 9.97초로 유독 긴데, 이 중 7.56초는 gpt oss 모델을 VRAM에 올리는 시간입니다.
실제 응답은 2.4초였습니다. 2회차부터는 이미 올라가 있어서 2초대로 떨어집니다.
평균 46.19 tok/s입니다.
두번째 기준은 통과입니다. 합격선이 20 tok/s였으니 두 배를 넘겼습니다.
그런데 이 숫자가 좀 이상합니다.
지난 글의 젬마4는 100% GPU로 돌면서 36.33 tok/s였습니다.
이번 gpt-oss는 30%가 CPU에 있는데 46.19 tok/s입니다.
VRAM이 아니라 CPU쪽에 밀려난 쪽이 더 빠릅니다!!?!
30%가 CPU인데 왜 더 빠를까
지난 글에서 이렇게 썼습니다.
“30%만 넘겼는데 속도는 50%를 잃은 거죠. 조금만 넘쳐도 크게 손해라는 뜻입니다.”
이번에도 정확히 30%가 넘어갔습니다. 그런데 손해가 없습니다.
차이는 MoE입니다.
젬마4는 모든 파라미터가 매 토큰마다 계산에 참여합니다.
CPU로 밀려난 29%도 예외가 아닙니다.
그래서 GPU가 자기 몫을 끝내도 CPU가 끝날 때까지 기다려야 했습니다. 매 토큰마다요.
gpt oss는 다릅니다.
20B가 통째로 쓰이는 게 아니라, 토큰 하나를 만들 때마다 일부만 깨어납니다. 나머지는 그냥 자고 있습니다.
CPU로 밀려난 30%가 대부분 자고 있는 부분이라면, 거기 있어도 손해가 없습니다. GPU는 기다릴 일이 없고요.
중요한 건 “얼마나 밀려났나”가 아니라 “밀려난 게 매번 쓰이나”였습니다.
지난 글에서 세운 법칙이 여기서 깨졌습니다. 정확히는, 그 법칙이 Dense 모델에만 해당하는 얘기였던 겁니다.
생각하는 방식도 다릅니다
출력 토큰을 보면 96개, 92개, 72개입니다.
지난번 젬마4는 240개, 515개, 292개였습니다. 인사말 하나에 초안을 다섯 번 고쳐 쓰면서요.
gpt oss도 생각은 합니다. Thinking...으로 시작해서 ...done thinking으로 끝나는 구간이 그겁니다.
젬마4가 답변 속에 숨겨놓은 걸 이쪽은 대놓고 보여줍니다.
다만 훨씬 간결합니다. 젬마4의 3분의 1도 안 씁니다.
재밌는 건 이쪽도 영어로 생각한다는 점입니다. 한국어로 물었는데 “The user says 안녕 which means Hello in Korean” 하면서 영어로 고민하다가, 답변만 한국어로 내놓습니다. 젬마4와 똑같습니다.
세번째, 컨텍스트는 어디까지 늘어날까?
ollama show gpt-oss:20b
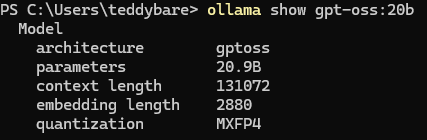
gpt oss는 context length가 131072입니다. 13만 토큰, 128K죠.
지난번 젬마4(Gemma 4)는 26만이었습니다. 절반입니다.
그런데 젬마4도 스펙이 26만이었지 실제로는 제 3060 12GB에서 12만까지밖에 못 갔습니다.
결국 쓸 수 있는 양은 비슷한 셈입니다.
파라미터는 20.9B, 양자화는 MXFP4로 잡혀 있습니다. 젬마4가 Q4_K_M이었던 것과 다른 방식입니다.
gpt oss num_ctx 값을 두 배씩 올려가며 어디서 무너지는지 확인해봤습니다.
| 컨텍스트 | VRAM | PROCESSOR | 속도 |
| 32K (기본) | 14 GB | 30%/70% CPU/GPU | 46.19 tok/s |
| 64K | 14 GB | 36%/64% CPU/GPU | 44.15 tok/s |
| 128K (최대) | 14 GB | 48%/52% CPU/GPU | 36.94 tok/s |
스펙 최대치인 128K까지 갔습니다. 세번째 기준도 통과입니다.
다만 공짜는 아니었습니다. CPU 비율이 30%에서 48%로 올라갔고, 속도는 46에서 37로 떨어졌습니다.
그런데 여기서 재밌는 게 하나 있습니다.
128K일 때 gpt-oss는 36.94 tok/s입니다.
지난 글의 젬마4는 100% GPU로 돌면서 36.33 tok/s였습니다.
절반이 CPU에 있는 20B 모델이, 전부 GPU에 올라간 12B 모델과 같은 속도입니다.
VRAM 표시가 계속 14GB로 같은 것도 눈에 띕니다. 컨텍스트를 네 배 늘렸는데 표시 용량이 안 변했습니다.
늘어난 캐시가 GPU가 아니라 CPU 쪽으로 밀려나서 그렇습니다.
CPU 비율이 30%에서 48%로 올라간 게 그 증거입니다.
결론: 기준 3개 중 2개 통과
첫번째, 100% GPU 탈락. 30%가 CPU로 밀려났습니다
두번째, 20 tok/s 이상 통과. 46.19 tok/s가 나왔습니다
세번째, 컨텍스트 한계 통과. 스펙 최대치 128K까지 갔습니다
첫 관문에서 떨어졌으니 실패한 것 같지만, 실제로 써보면 얘기가 다릅니다.
좋았던 것
- 13GB 모델이 12GB 카드에서 돌아갑니다
- 30%가 CPU인데 46 tok/s. 젬마4보다 27% 빠릅니다
- 스펙 최대치인 128K까지 전부 씁니다
- 128K에서 절반이 CPU로 밀려나도 37 tok/s를 유지합니다
아쉬운 것
- 100% GPU는 불가능합니다. VRAM이 2GB 부족합니다
- 컨텍스트를 최대로 올리면 속도가 20% 깎입니다
지난 글에서 이렇게 썼습니다.
“30%만 넘겼는데 속도는 50%를 잃은 거죠. 조금만 넘쳐도 크게 손해라는 뜻입니다.”
이번 글에서 그 법칙이 깨졌습니다. 정확히는, Dense 모델에만 해당하는 얘기였던 겁니다.
MoE 모델은 VRAM에서 넘쳐도 생각보다 멀쩡합니다. 밀려난 부분이 매번 쓰이는 게 아니니까요.
그래서 결론은
기준 3개 중 하나를 못 넘겼습니다. 100% GPU는 실패했습니다.
그런데 이 기준, 애초에 Dense 모델을 생각하고 만든 겁니다.
100% GPU를 조건으로 걸었던 이유는 CPU로 넘어가면 느려지기 때문이었습니다. 그런데 gpt-oss는 30%가 CPU에 있어도 46 tok/s가 나옵니다. 느려지지 않았으니, 이 기준을 못 넘긴 게 문제가 되지 않습니다.
결론부터 말하면, gpt-oss 20B는 RTX 3060 12GB에서 충분히 쓸 만합니다.
- 속도는 젬마4보다 빠릅니다. 46 tok/s면 읽는 속도보다 훨씬 위입니다
- 컨텍스트는 스펙 최대치인 128K를 다 씁니다. 문서 몇 개는 통째로 넣고 대화할 수 있습니다
- 128K까지 올려도 37 tok/s를 유지합니다. 여기서도 젬마4의 100% GPU 속도와 같습니다
VRAM 12GB에 13GB 모델을 올린다는 게 상식적으로는 안 되는 일인데, 실제로는 됩니다.
그것도 더 작은 모델보다 빠르게요.
12GB 카드를 쓰신다면 이건 꽤 중요한 얘기입니다.
“모델 크기가 VRAM보다 크면 안 된다”는 상식이 MoE에서는 통하지 않습니다.
VRAM만 보고 포기했던 모델도, MoE라면 한 번쯤 시도해볼 가치가 있습니다.
물론 gpt-oss 20B도 Fable 5나 GPT-5.6 Sol 같은 것과 비교하면 급이 다릅니다.
너무 큰 기대는 하지 않는 게 좋습니다.
하지만 몇 년 전에 산 그래픽카드 한 장으로 20B 모델을 이 속도로 돌릴 수 있다는 건, 저한테는 충분히 놀라운 결과였습니다.