
지난 글에서 J4125 미니PC에 로컬 LLM을 올려봤습니다.
초당 2토큰이었습니다. “안녕하세요” 한마디에 1분이 걸렸죠.
그 글은 이렇게 끝냈습니다. “사람이 앞에서 기다리지 않는 작업이라면 초당 2토큰이어도 상관없다”고요.
그런데 생각해보니 이 블로그는 그동안 텍스트만 다뤘습니다.
젬마4 12B, gpt-oss 20B, Qwen3.6 35B-A3B, 그리고 이미지 생성까지 갔는데 소리는 한 번도 안 건드렸습니다.
그래서 이번엔 RTX 3060 Whisper입니다.
음성 파일을 넣으면 텍스트로 받아써주는 STT(Speech to Text)입니다.
결론부터 말하면 잘 됩니다. RTX 3060 Whisper로 83분짜리 한국어 음성을 14분에 처리했습니다.
다만 숫자를 재는 과정에서 두 번 크게 헤맸고, 그게 이 글의 절반입니다.
RTX 3060 Whisper 환경 확인
시작 전에 GPU 상태부터 봤습니다.
nvidia-smi
12288MiB 중 670MiB만 쓰고 있습니다. 온도 46도, 전력 16W입니다.
나중에 추론할 때 이 숫자가 어떻게 변하는지가 이 글의 볼거리 중 하나입니다.
여기서 하나 짚고 갈 게 있습니다. 전력 상한이 127W로 나오는데 3060 정격은 170W입니다.
MSI Afterburner로 파워 리미트를 75%로 걸어둔 상태입니다.
이 글의 모든 RTX 3060 Whisper 속도 수치는 전력이 25% 깎인 상태에서 나온 값이라고 보시면 됩니다.
다음은 파이썬이 GPU를 실제로 잡는지입니다.
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.get_device_name(0))"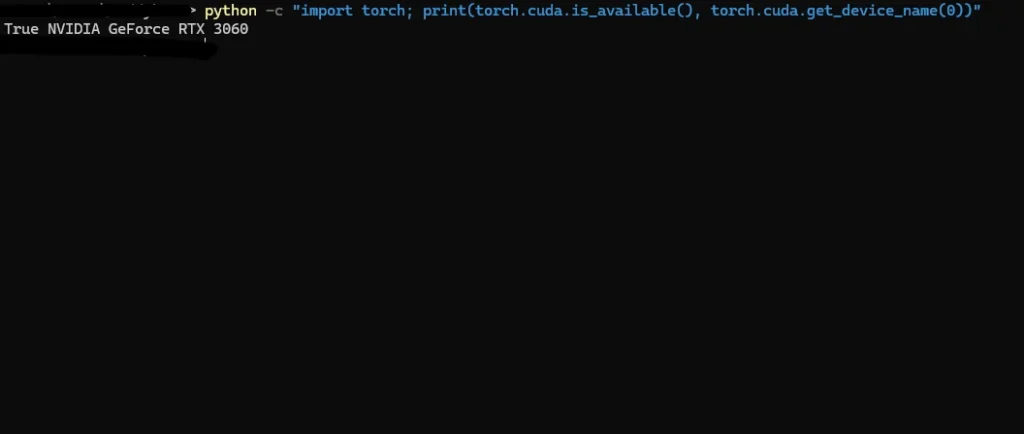
True가 나왔습니다. 여기서 False가 나오면 뒤가 전부 막히니 제일 먼저 확인하셔야 합니다.
설치된 버전도 확인했습니다.
pip install datasets soundfile
pip list | Select-String "datasets|soundfile|torch"
datasets 5.0.1, soundfile 0.13.1, torch 2.5.1+cu121입니다.
이 조합을 기억해두세요. 잠시 뒤에 문제를 일으킵니다.
참고로 이번 작업은 윈도우 PowerShell에서 했습니다.
grep 같은 리눅스 명령이 안 먹으니 Select-String으로 바꿔 쓰셔야 합니다.
한국어 음성 데이터는 FLEURS로
RTX 3060 Whisper의 정확도를 재려면 정답이 붙어 있는 음성이 필요합니다.
직접 녹음하면 정답은 알지만 남들과 비교할 기준이 없습니다.
그래서 FLEURS를 골랐습니다.
구글이 공개한 다국어 음성 데이터셋인데, 상용 STT 업체들이 성능을 발표할 때 쓰는 그 데이터셋입니다.
한국어처럼 음절 단위 언어는 단어 기준 WER 대신 글자 기준 CER로 평가하는 게 표준인데, FLEURS는 그 비교표에 거의 항상 올라갑니다.
즉 RTX 3060 Whisper로 잰 숫자를 남의 발표 수치 옆에 놓을 수 있다는 뜻입니다.
from datasets import load_dataset

ds = load_dataset("google/fleurs", "ko_kr", split="test")

print(f"샘플 수: {len(ds)}")
print(f"첫 문장: {ds[0]['transcription']}")
여기서 좀 이상한 게 보입니다.
코드에는 분명 split=”test”라고 썼는데, 받고 있는 파일은 train-00000-of-00001입니다. 용량도 1.81GB고요.
datasets 라이브러리가 데이터셋 전체를 먼저 내려받고 나서 split을 잘라내는 구조라서 그렇습니다.
test만 필요해도 train과 validation까지 다 받습니다. 합치면 2.2GB쯤 됩니다.
같이 뜨는 symlink 경고도 윈도우 사용자라면 알아두시는 게 좋습니다.
윈도우가 심볼릭 링크를 지원하지 않아서 파일을 복사본으로 저장한다는 뜻입니다. 즉 디스크를 더 씁니다.
개발자 모드를 켜거나 관리자 권한으로 실행하면 사라지는데, 용량에 여유가 있으면 그냥 두셔도 동작에는 문제가 없습니다.
삽질 하나. 시키는 대로 설치했는데 더 안 됩니다
RTX 3060 Whisper를 돌려보기도 전에, 데이터를 준비하는 단계에서 먼저 막혔습니다.
다운로드는 끝났는데 마지막 줄에서 멈췄습니다.
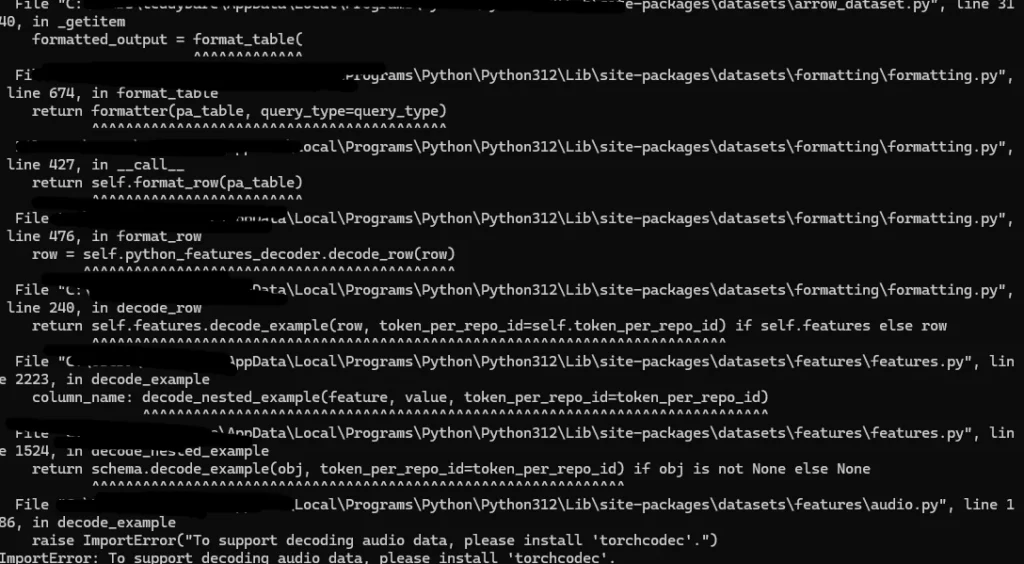
샘플 수 382까지는 정상입니다. 그런데 ds[0]으로 첫 문장을 꺼내려는 순간 터졌습니다.
메시지는 친절합니다. 오디오를 디코딩하려면 torchcodec을 설치하라고 합니다.
텍스트만 읽을 때는 문제가 없는데, 행 전체를 꺼내면 오디오까지 디코딩하려다 걸립니다.
시키는 대로 했습니다.
pip install torchcodec설치는 깔끔하게 됐습니다. 그리고 다시 실행했더니 이번엔 이게 나왔습니다.
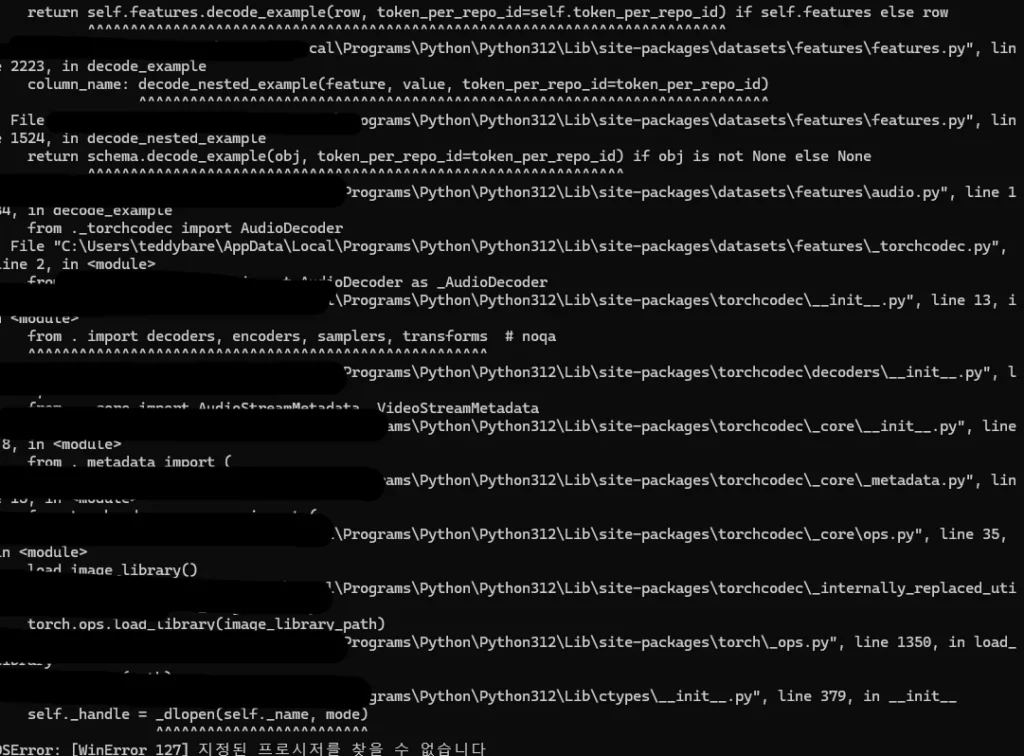
WinError 127. 지정된 프로시저를 찾을 수 없습니다.
맨 아래 흐름을 따라가 보면 원인이 보입니다.
torchcodec이 load_image_library()를 호출하고, 그게 ctypes.CDLL로 DLL을 열려다가 실패했습니다.
WinError 127은 파일을 못 찾은 게 아닙니다. DLL은 찾았는데 그 안에서 필요한 함수를 못 찾았다는 뜻입니다.
아까 확인한 torch 2.5.1과 지금 설치된 torchcodec 0.16이 서로 기대하는 버전이 안 맞아서 생기는 전형적인 증상입니다.
여기서 선택지가 두 개였습니다. torch를 torchcodec에 맞춰 올리거나, torchcodec을 안 쓰거나.
전자는 안 하기로 했습니다.
지금 이 3060 환경은 그동안 젬마4부터 ComfyUI까지 다 돌아가던 조합입니다. 잘 굴러가는 걸 굳이 흔들 이유가 없습니다.
그래서 후자로 갔습니다. 오디오 디코딩을 아예 끄고, 원본 바이트를 받아서 soundfile로 직접 읽는 방식입니다.
import io, numpy as np, soundfile as sf
from datasets import load_dataset, Audio

ds = load_dataset("google/fleurs", "ko_kr", split="test")
ds = ds.cast_column("audio", Audio(decode=False))

sr = None
chunks, refs, total = [], [], 0

for item in ds:
    data, rate = sf.read(io.BytesIO(item["audio"]["bytes"]))
    if sr is None:
        sr = rate
    chunks.append(data)
    chunks.append(np.zeros(int(rate * 0.5)))
    refs.append(item["transcription"])
    total += len(data) / rate + 0.5

sf.write("fleurs_ko_full.wav", np.concatenate(chunks), sr)
with open("fleurs_ko_full.txt", "w", encoding="utf-8") as f:
    f.write("\n".join(refs))

print(f"{total/60:.1f}분, {len(refs)}문장, {sr}Hz")
핵심은 Audio(decode=False) 한 줄입니다.
이러면 datasets가 오디오를 건드리지 않고 원본 바이트만 넘겨주니 torchcodec이 필요 없어집니다.
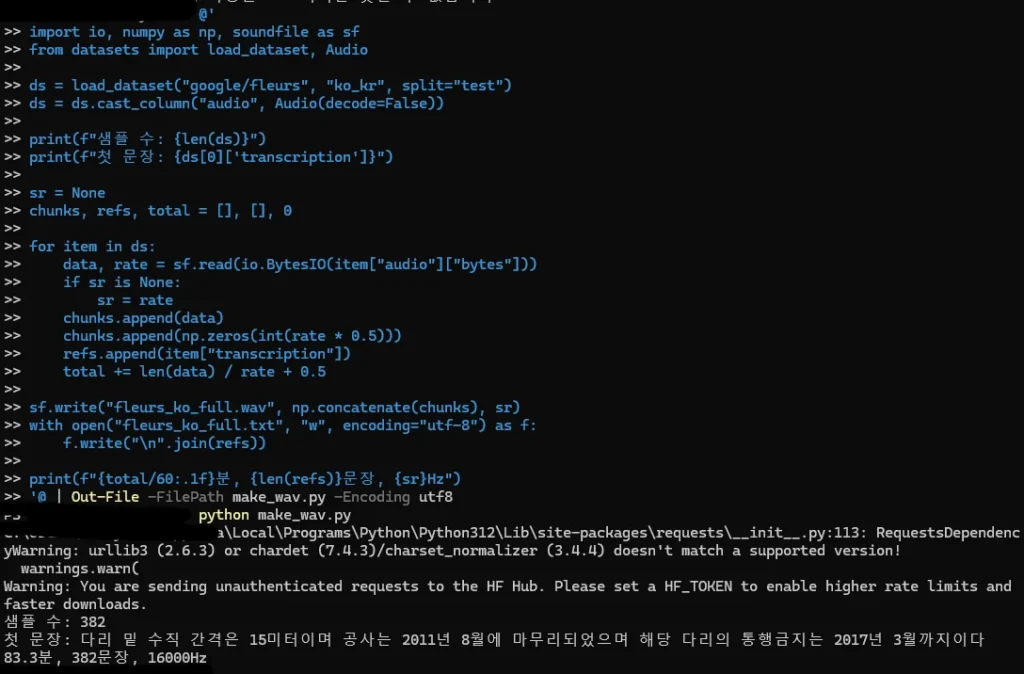
383문장이 아니라 382문장, 총 83.3분, 16000Hz로 나왔습니다.
첫 문장도 한글이 안 깨지고 제대로 찍혔습니다.
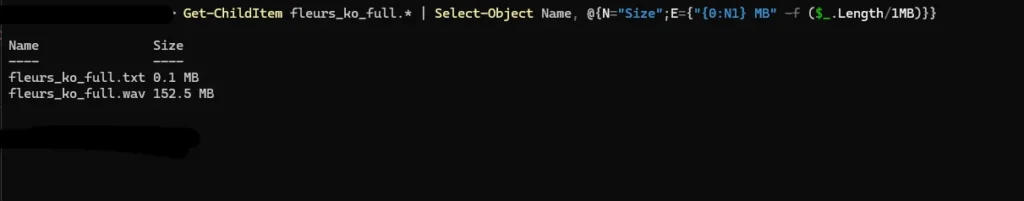
wav가 152.5MB입니다. 16kHz 모노 무압축이라 83분에 이 정도 나옵니다.
txt는 0.1MB인데 여기에 정답 382문장이 들어 있습니다. 나중에 채점할 때 쓸 파일입니다.
RTX 3060 Whisper 실행, VRAM은 6GB
모델은 faster-whisper의 large-v3로 정했습니다.
원본 Whisper보다 빠르고 VRAM도 적게 씁니다.
pip install faster-whisperimport time
from faster_whisper import WhisperModel
model = WhisperModel("large-v3", device="cuda", compute_type="float16")
start = time.time()
segments, info = model.transcribe("fleurs_ko_full.wav", language="ko", beam_size=5)
lines = [seg.text.strip() for seg in segments]
elapsed = time.time() - start
with open("result.txt", "w", encoding="utf-8") as f:
f.write("\n".join(lines))
print(f"소요 {elapsed/60:.1f}분")
print(f"실시간 대비 {(83.3*60)/elapsed:.1f}배속")
print(f"세그먼트 {len(lines)}개")첫 실행 때 모델 3GB를 내려받습니다. 그게 끝나면 조용해지는데, 그때가 추론이 시작된 시점입니다.
터미널을 하나 더 띄워서 GPU를 봤습니다.

숫자가 완전히 달라졌습니다.
| 항목 | 유휴 | 추론 중 |
|---|---|---|
| VRAM | 670MiB | 5837MiB |
| GPU 사용률 | 0% | 95% |
| 온도 | 46도 | 70도 |
| 전력 | 16W | 127W / 127W |
| 팬 | 0% | 52% |
전력이 상한에 딱 붙었습니다. 앞서 말씀드린 파워 리미트 75%가 걸린 그 127W입니다.
즉 이 카드는 지금 낼 수 있는 만큼 다 내고 있습니다.
VRAM은 고정이 아니었습니다. 보고 있으면 5.0GB에서 6.4GB 사이를 계속 오르내립니다.
Whisper가 30초 단위로 잘라서 처리하는데 구간마다 발화량이 다르고, beam_size 5로 후보를 다섯 개씩 들고 있어서 그렇습니다.
이게 왜 중요하냐면, 8GB 카드를 쓰시는 분이 “6GB면 되겠네” 하고 다른 걸 같이 올렸다가 피크 구간에서 터질 수 있기 때문입니다.
평균이 아니라 최대치인 6.4GB를 기준으로 잡으셔야 합니다.
작업 관리자로도 같이 봤습니다.
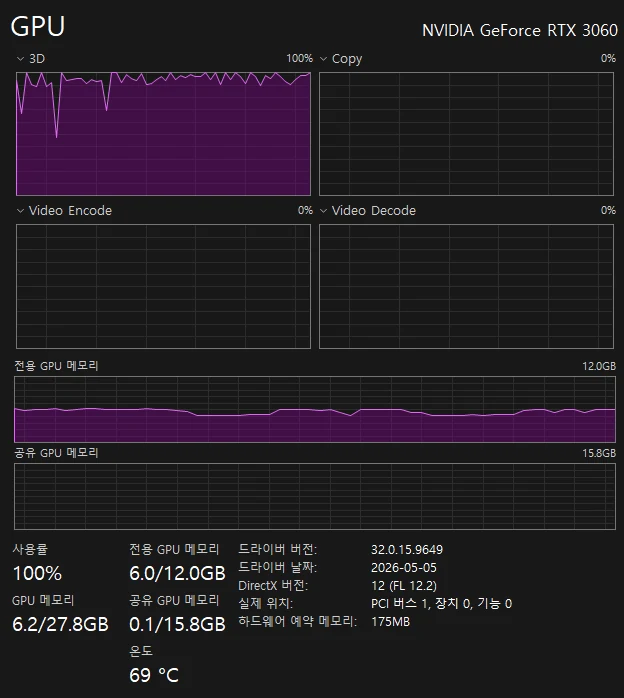
사용률 100%, 전용 GPU 메모리 6.0GB, 온도 69도입니다.
3D 그래프가 톱니처럼 오르내리는 게 보이는데, 청크 단위로 처리하는 특성이 그대로 드러납니다.
그리고 14분 뒤에 결과가 나왔습니다.
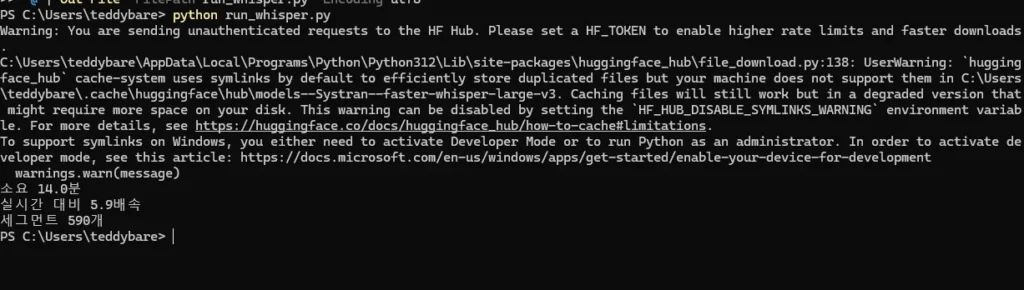
83.3분 음성을 14.0분에 처리했습니다. 실시간 대비 5.9배속입니다.
1시간짜리 회의 녹음이라면 10분 만에 텍스트가 나온다는 뜻입니다.
J4125에서 초당 2토큰을 눈으로 세며 기다렸던 걸 생각하면 RTX 3060 Whisper는 다른 세상입니다.
다만 여기도 불편한 점이 하나 있습니다. 14분 동안 화면에 아무것도 안 나옵니다.
진행률도 없고 중간 결과도 없습니다. 끝나야 한꺼번에 나옵니다.
세그먼트로 하나씩 받으면서 출력하면 실시간으로 볼 수 있습니다.
for seg in segments:
    print(f"[{seg.end/60:.1f}분 / 83.3분] {seg.text.strip()}")
다음에 하실 분은 이렇게 쓰시는 걸 권합니다. 답답함이 확실히 덜합니다.
받아쓴 결과, 잘하는데 가끔 지어냅니다
RTX 3060 Whisper가 받아쓴 결과를 열어봤습니다.
참고로 PowerShell에서 그냥 Get-Content를 하면 한글이 다 깨지니 -Encoding utf8을 꼭 붙이셔야 합니다.
Get-Content result.txt -Head 5 -Encoding utf8
Get-Content fleurs_ko_full.txt -Head 5 -Encoding utf8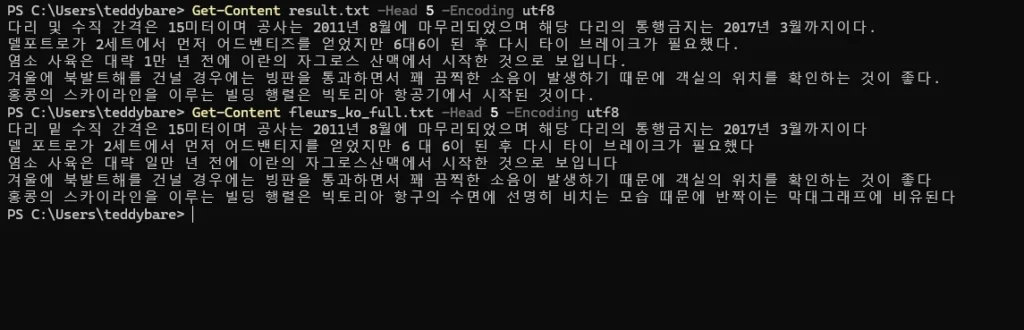
위가 Whisper 결과, 아래가 정답입니다. 다섯 문장만 봐도 유형이 세 가지로 나뉩니다.
첫째, 틀린 게 아니라 표기가 다른 경우입니다.
정답에는 구두점이 없는데 Whisper는 마침표를 붙입니다.
“6 대 6″을 “6대6″으로, “자그로스산맥”을 “자그로스 산맥”으로 띄어쓰기도 다릅니다.
“일만 년 전”을 “1만 년 전”으로 쓴 것도 마찬가지입니다. 의미는 같은데 글자는 다릅니다.
둘째, 진짜 오류입니다.
“다리 밑”을 “다리 및”으로 들었습니다. 소리가 비슷해서 헷갈린 경우죠.
“어드밴티지”는 “어드벤티즈”가 됐고, “델 포트로”는 “델포트로”로 붙었습니다. 외래어와 인명에 약합니다.
셋째, 이게 문제입니다.
다섯 번째 문장을 보세요.
| 내용 | |
|---|---|
| 정답 | 홍콩의 스카이라인을 이루는 빌딩 행렬은 빅토리아 항구의 수면에 선명히 비치는 모습 때문에 반짝이는 막대그래프에 비유된다 |
| 결과 | 홍콩의 스카이라인을 이루는 빌딩 행렬은 빅토리아 항공기에서 시작된 것이다 |
“항구”를 “항공기”로 잘못 들은 것까지는 그렇다 칩시다.
그런데 그 뒤로 문장을 통째로 지어냈습니다. 원문에 없는 내용인데 한국어로는 아주 자연스럽습니다.
지난 J4125 글에서 모델이 자기가 돌아가는 CPU 스펙을 확신에 차서 틀리게 답한 적이 있었죠.
구조가 똑같습니다. 매끄럽게 틀립니다.
받아쓰기에서 이건 요약보다 위험합니다.
원문을 모르는 상태에서 결과만 보면 틀린 줄도 모르니까요.
삽질 둘. 채점을 하려는데 숫자가 이상합니다
정확도를 숫자로 내보기로 했습니다. 앞서 말한 CER입니다.
100글자 중 몇 글자를 틀렸나를 백분율로 나타낸 값이고, 낮을수록 좋습니다.
pip install jiwer정답 파일과 결과 파일이 이미 있으니 그냥 비교하면 될 줄 알았습니다. 그런데 이렇게 나왔습니다.
1. 원본 그대로        CER 30.45%
2. 구두점 제거        CER 27.85%
3. 구두점+띄어쓰기    CER 29.73%
30%면 세 글자에 한 글자를 틀렸다는 뜻입니다.
그런데 방금 눈으로 본 문장들은 거의 정확했습니다. 뭔가 이상합니다.
더 이상한 건 3번입니다. 띄어쓰기까지 무시하고 채점했는데 2번보다 오히려 높습니다.
기준을 관대하게 했는데 점수가 나빠지는 건 계산이 잘못됐다는 신호입니다.
원인은 결과 화면에 이미 나와 있었습니다.
정답은 382문장인데 Whisper가 뱉은 세그먼트는 590개입니다.
Whisper는 원본의 문장 경계를 모릅니다. 자기 기준으로 끊습니다.
그러니 순서대로 짝을 지으면 앞의 몇 개만 우연히 맞고 그 뒤로는 전부 한 칸씩 밀립니다.
실제로 문장별로 채점해봤더니 이렇게 나왔습니다.
문장별 평균 CER   100.96%
CER 5% 미만       4문장
CER 50% 초과      378문장
평균 100%가 넘습니다. 최악의 사례를 뽑아보니 이랬습니다.
| 정답 | 교전이 발발한 직후 영국은 독일에 대한 해상 봉쇄를 시작한다 |
| 결과 | 지하철의 정규 안내방송은 카탈로니아어로만 제공되나… |
해상 봉쇄와 지하철 안내방송입니다. 아예 다른 문장끼리 짝지어진 겁니다.
RTX 3060 Whisper가 못한 게 아니라 채점 방식이 틀린 것이었습니다.
정답과 결과의 글자 수를 세보니 17,698자 대 18,995자로 1,297자가 더 많았습니다.
앞서 본 환각 때문에 없는 내용이 늘어난 만큼, 전체를 이어붙여 비교하는 방식은 처음부터 성립하지 않았습니다.
제대로 재려면 문장 단위로 넣어야 합니다
RTX 3060 Whisper의 정확도를 제대로 재려면 결국 방식을 바꿔야 했습니다.
83분을 통째로 넣는 대신, 문장 하나를 임시 wav로 저장해서 하나씩 넣고 그 자리에서 채점하는 겁니다.
이러면 원본과 결과가 1대1로 대응됩니다.
N = 100

for i, item in enumerate(ds):
    if i >= N: break
    data, rate = sf.read(io.BytesIO(item["audio"]["bytes"]))
    sf.write("_tmp.wav", data, rate)
    segs, _ = model.transcribe("_tmp.wav", language="ko", beam_size=5)
    hyp = " ".join(s.text for s in segs)
    scores.append(jiwer.cer(norm(item["transcription"]), norm(hyp)))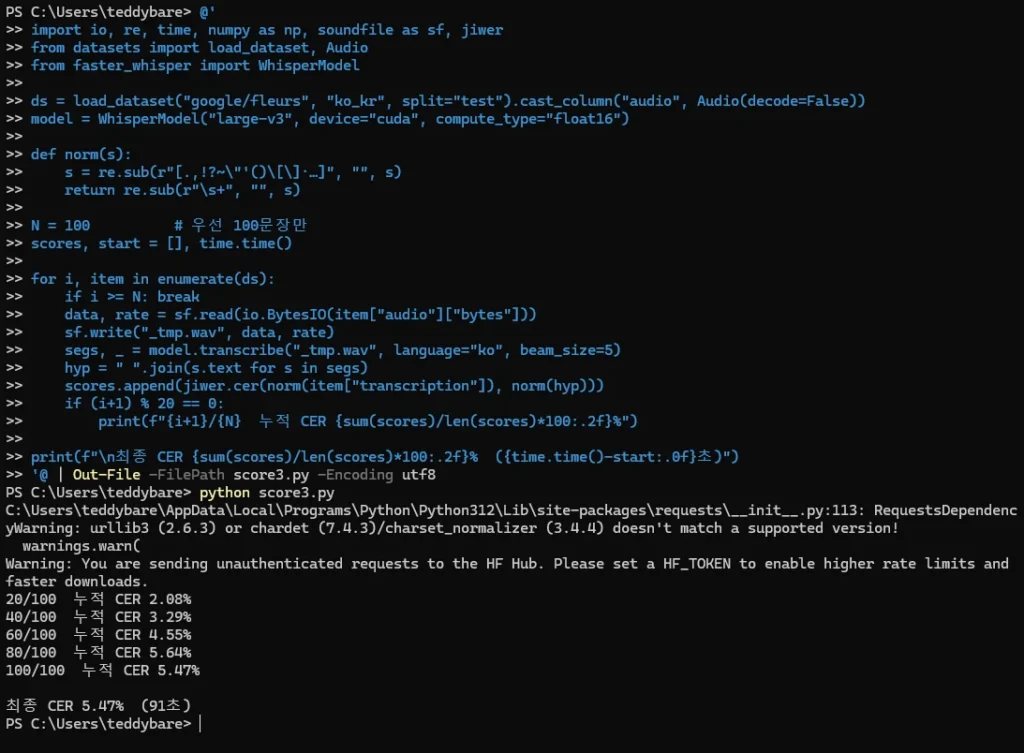
CER 5.47%입니다. 100문장에 91초 걸렸습니다.
30%가 아니라 5%대. 이게 RTX 3060 Whisper large-v3의 실제 한국어 성능입니다.
중간 수치를 보면 20문장에서 2.08%, 40문장에서 3.29%, 60문장에서 4.55%로 계속 올라가다가 100문장에서 5.47%로 안정됩니다.
표본이 적을 때 수치가 얼마나 흔들리는지 보여주는 그래프이기도 합니다.
“20문장 테스트해보니 CER 2%더라” 같은 글을 믿으면 안 되는 이유입니다.
RTX 3060 Whisper, 정리하면
- RTX 3060 Whisper의 속도는 충분합니다. 83.3분 한국어 음성을 14.0분에 처리했습니다. 실시간 대비 5.9배속이고, 파워 리미트를 75%로 걸어둔 상태에서 나온 숫자입니다.
- VRAM은 최대 6.4GB를 봐야 합니다. 평균은 6GB 안팎이지만 구간에 따라 5.0GB에서 6.4GB까지 오르내립니다. 12GB 카드면 절반이 남지만, 8GB 카드에서 다른 걸 같이 올릴 생각이라면 최대치로 계산하셔야 합니다.
- torchcodec은 설치가 답이 아닐 수 있습니다. datasets 최신 버전이 오디오 디코딩을 torchcodec에 넘기는데, 윈도우에서 torch 버전과 어긋나면 WinError 127이 납니다. Audio(decode=False)로 우회하는 게 잘 돌아가는 환경을 지키는 방법입니다.
- 정확도는 CER 5.47%입니다. 다만 구두점과 띄어쓰기를 어떻게 처리하느냐에 따라 숫자가 달라집니다. 어디선가 CER 수치를 보시면 어떻게 쟀는지부터 확인하셔야 합니다.
- 속도 재는 법과 정확도 재는 법이 다릅니다. 통째로 넣으면 빠르지만 문장 경계가 어긋나 채점이 불가능해집니다. 채점하려면 문장 단위로 잘라 넣어야 하고, 그러면 속도 이점이 줄어듭니다. 둘을 한 번에 재려다 30%라는 엉터리 숫자를 봤습니다.
- 매끄럽게 틀립니다. 잘못 들은 단어에서 시작해 문장을 통째로 지어냅니다. 한국어로는 자연스러워서 원문을 모르면 알아채기 어렵습니다.
그래서 RTX 3060 Whisper는 실용적입니다.
1시간 녹음이 10분이면 텍스트가 되고, 정확도도 95%에 가깝습니다.
회의록 초안이나 영상 자막 초안으로는 충분히 쓸 만합니다.
다만 초안이라는 말에 방점이 있습니다.
95%가 맞는다는 건 5%가 틀린다는 뜻이고, 그 5%가 조용히 그럴듯한 문장으로 채워져 있으니까요.
다만 초안이라는 말에 방점이 있습니다.
95%가 맞는다는 건 5%가 틀린다는 뜻이고, 그 5%가 조용히 그럴듯한 문장으로 채워져 있으니까요.
결국 RTX 3060 Whisper는 사람이 검토할 원고를 만들어주는 도구입니다.
한 시간 듣고 받아치는 일을 십 분으로 줄여주는 것만으로도 충분하다고 봅니다.
이상 글 마치겠습니다!